как написать свой язык программирования на пайтон
Python является одним из самых популярных языков программирования в мире благодаря своей простоте и мощности. Одной из самых захватывающих возможностей Python является возможность создания собственного языка программирования. Несмотря на то, что это может показаться сложным, с использованием Python вы можете создать свой собственный язык программирования, который будет соответствовать вашим потребностям и задачам. В этой статье мы рассмотрим основные шаги, которые вам потребуются, чтобы создать свой язык программирования на Python.
Шаг 1: Определите грамматику вашего языка
Первым шагом в создании собственного языка программирования является определение грамматики. Грамматика является набором правил, описывающих синтаксис вашего языка. Например, вы должны определить, каким образом обозначаются переменные, условные операторы, циклы и т.д. Существует множество инструментов, таких как ANTLR или PLY, которые могут помочь вам определить и реализовать грамматику вашего языка.
Шаг 2: Создайте лексер и парсер
После определения грамматики, вы должны создать лексер и парсер для вашего языка. Лексер разбивает входной текст на отдельные лексемы или токены, такие как идентификаторы, операторы или числа. Парсер анализирует последовательность лексем, чтобы установить синтаксическую структуру вашего языка. Вы можете использовать инструменты, такие как PLY или PyParsing, для реализации лексера и парсера на Python.
Шаг 3: Определите абстрактное синтаксическое дерево (АСД)
Абстрактное синтаксическое дерево (АСД) представляет структуру вашего программного кода в виде дерева, где каждый узел представляет конкретную конструкцию языка, такую как оператор, выражение или блок кода. АСД является промежуточным представлением кода вашего языка и будет использоваться для выполнения или компиляции программ. Вы можете определить АСД с использованием библиотеки AST (абстрактное синтаксическое дерево) Python или создать свою собственную структуру данных.
Шаг 4: Реализуйте интерпретатор или компилятор
После определения АСД вы должны реализовать интерпретатор или компилятор для вашего языка. Интерпретатор выполняет программу непосредственно на основе АСД, в то время как компилятор переводит программу в машинный код или другой язык программирования. В Python вы можете использовать библиотеку для выполнения программного кода из АСД или использовать инструменты, такие как LLVM, для создания компилятора.
Шаг 5: Проверьте и оптимизируйте ваш язык
После создания своего языка программирования важно проверить и оптимизировать его производительность и функциональность. Вы можете создать тестовые сценарии и провести ряд тестов, чтобы проверить, работает ли ваш язык как ожидалось. Вы также можете внедрить различные оптимизации, чтобы улучшить производительность и эффективность вашего языка.
В заключение, создание собственного языка программирования на Python может быть интересным и захватывающим опытом. С помощью правильных инструментов и шагов вы можете создать язык, который соответствует вашим потребностям и позволяет вам выразить свое видение программирования. Сейчас вы вооружены базовыми знаниями по созданию собственного языка программирования на Python и готовы начать свое творчество в мире разработки программного обеспечения!
Как создать лексер на python
Создание компилятора на Python
1. Введение
1.1 Цель
При проектировании какого-либо компилятора или интерпретатора в качестве инструмента, как правило, выбирают язык C. А что если планируется создать «небольшой язык программирования» , просто так, забавы ради (или, может быть, для более серьёзного применения)? Чего беспокоиться, если вы обладаете достаточно мощным инструментом — интерпретатором Python!
1.2 Инструменты
В рабочий каталог нужно переписать модули lex.py и yacc.py. Само собой, потребуется и Python версии 2.1 или выше.
2. Первый шаг
Перед тем, как углубиться в детали реализации, пройдемся по основным терминам и понятиям.
2.1 Лексемы
Что такое лексемы? Лексемы — это символы, подобные +, -, * или /, или это слова, такие как begin, end, if или while, которые могут выступать в качестве операндов в выражениях, зарезервированных или ключевых слов и т.п. Лексемы должны быть определены как регулярные выражения.
2.2 Определение языка программирования
Поскольку пишется компилятор для нашего конкретного языка программирования, то следует начать с определения этого языка, записав для него набор грамматических правил. Например, если предполагается введение в язык конструкции ‘if-then-else-endif’, то правило достаточно просто можно записать так:
if_statement : IF LPAREN statement RPAREN multiple-statements ELSE multiple-statements ENDIF
где (1) IF, LPAREN, RPAREN, ELSE и ENDIF — лексемы для синтаксических единиц if , ( , ) , else и endif соответственно. (2) ‘statement’ и ‘multiple-statements’ — различные конструкции, для которых должны быть определены свои правила.
2.3 Грамматический разбор
Говоря простыми словами, грамматический разбор (в просторечие — парсинг, от английского to parse, не путать с пирсингом — прим. ред. 🙂 есть проверка соответствия исходного текста программы заданному набору правил. Существуют различные методы разбора, но нам нет нужды вдаваться в детали. Вам достаточно лишь знать, что, имея набор правил (см. пример выше), синтаксический анализатор производит разбор текста программы в соответствии с этим набором.
3. Реализация
Итак, приступим к созданию компилятора. Процесс компиляции делится на несколько этапов.
- Выделение лексем
- Грамматический разбор
- Выполнение действий, определяемых семантикой языка.
- Создание промежуточного кода.
- Оптимизация
- Создание результирующего кода.
3.1 Набор правил
Как уже упоминалось, сначала необходимо определить язык программирования, для которого реализуется компилятор. Определитесь, какой набор конструкций и операторов вы хотите предоставить. Такие конструкции, как ‘while’, ‘if’, ‘ assignment statements’ (операция присваивания) и пр. обычно имеются в большинстве языков программирования, так же как и арифметические операторы, такие как +, -, *, / и пр. Затем необходимо создать набор грамматических правил для вашего языка программирования. Набор правил для поддержки операции присваивания приводится ниже.
assign_statement : VAR EQUALS statement statement : statement ADDOP term | statement SUBOP term | term term : term MULOP factor | term DIVOP factor | factor factor : VAR | NUM | LPAREN statement RPAREN
Здесь и далее мы будем придерживаться следующих соглашений о написании лексем и правил. Лексемы мы будем записывать в верхнем регистре (NUM, VAR, EQUALS, ADDOP, SUBOP, MULOP, DIVOP, LPAREN, RPAREN), а правила (assign_statement, statement, term, factor) — в нижнем.
3.2 Определение лексем и их анализ
import lex # Список лексем. Обязателен. tokens = ( 'NUM', 'VAR', 'EQUALS', 'ADDOP', 'SUBOP', 'MULOP', 'DIVOP', 'LPAREN', 'RPAREN' ) # Регулярные выражения для выделения лексем. t_VAR = r'[a-zA-Z_][\w_]*' t_EQUALS = r'=' t_ADDOP = r'\+' t_SUBOP = r'-' t_MULOP = r'\*' t_DIVOP = r'/' t_LPAREN = r'\(' t_RPAREN = r'\)' # Регулярное выражение, требующее дополнительных действий. def t_NUM(t) : r'\d+' try: t.value = int(t.value) except ValueError: print "Строка %d: Число %s слишком велико!" % (t.lineno, t.value) t.value = 0 return t # Правило трассировки номеров строк. def t_newline(t): r'\n+' t.lineno += len(t.value) # Строка, содержащая игнорируемые символы (пробелы и символы табуляции). t_ignore = ' \t' # Правило обработки ошибок def t_error(t): print "Недопустимый символ '%s'" % t.value[0] t.skip(1) # Создать анализатор lex.lex() # Получить данные со стандартного ввода data = raw_input() lex.input(data) # Выделение лексем while 1 : tok = lex.token() if not tok : break print tok
Если вы хотите использовать зарезервированные слова, то, как правило, достаточно добавить соответствующее имя (идентификатор) и создать функцию, реализующую действие зарезервированного слова, как показано ниже:
reserved = < 'if' : 'IF', 'then' : 'THEN', 'else' : 'ELSE', 'while' : 'WHILE', . >def t_VAR(t): r'[a-zA-Z_][\w_]*' t.type = reserved.get(t.value,'ID') # Проверка на зарезервированное слово return t
3.3 Грамматический разбор
# Yacc example import yacc # Получить таблицу лексем от лексического анализатора, # который был создан нами ранее # Для этого. from ourlex import tokens __var_names = <> def p_assign_statement(t) : 'assign_statement : VAR EQUALS statement' __var_names[t[1]] = t[3] def p_statement_plus(t) : 'statement : statement ADDOP term' t[0] = t[1] + t[3] def p_statement_minus(t) : 'statement : statement SUBOP term' t[0] = t[1] - t[3] def p_statement_term(t) : 'statement : term' t[0] = t[1] def p_term_times(t) : 'term : term MULOP factor' t[0] = t[1] * t[3] def p_term_div(t) : 'term : term DIVOP factor' t[0] = t[1] / t[3] def p_term_factor(t) : 'term : factor' t[0] = t[1] def p_factor_num(t) : 'factor : NUM' t[0] = t[1] def p_factor_var(t) : 'factor : VAR' if __var_names.has_key(t[1]) : t[0] = __var_names[t[1]] else : print "Имя переменной", t[1], " в строке ", t.lineno(1), "не определено." def p_factor_expr(t): 'factor : LPAREN statement RPAREN' t[0] = t[2] # Обработка синтаксических ошибок def p_error(t): print "Синтаксическая ошибка!" # Создать грамматический анализатор yacc.yacc() while 1: try: s = raw_input('enter > ') except EOFError: break if not s: continue yacc.parse(s)
Здесь каждая функция принимает единственный аргумент t — массив (на самом деле удобный Python’овый не-модифицируемый «массивосписок» — tuple. прим. ред.), содержащий грамматические элементы:
def p_statement_plus(t): 'statement : statement ADDOP term' # ^ ^ ^ ^ # t[0] t[1] t[2] t[3] t[0] = t[1] + t[3]
3.4 Семантика
Семантика определяет последовательность действий, которые должен выполнить грамматический анализатор, когда ему удается свести входной поток до одного конкретного правила. В нашем примере семантика соответствует программе-интерпретатору. В случае простого компилятора, результатом работы может оказаться соответствующий правилу ассемблерный код.
Предположим, что в результате работы компилятора должен получаться код на языке ассемблера для процессора 8086. Примем за правило, что регистр ‘bx’ используется для хранения промежуточных результатов. Встретив очередной операнд, необходимо содержимое регистра ‘ax’ переписать в регистр ‘bx’, после чего в регистр ‘ax’ занести новый операнд. Таким образом, последний встреченный операнд (или результат операции) всегда будет содержаться в регистре ‘ax’.
def p_factor_num(t) : 'factor : NUM' __output_fp.write("\tmov bx,ax\n"%f) # bx
где, '__output_fp' -- дескриптор результирующего файла.
После того, как операнды подготовлены к выполнению операции (унарной или бинарной), мы можем описать семантику операции, например сложения:
def p_statement_plus(t) : 'statement : statement ADDOP term' __output_fp.write("\tadd ax,bx\n") # ax
Аналогичным образом, встретив объявление переменной, можно предусмотреть выбрать регистр процессора для ее хранения (локальные переменные предпочтительнее размещать на стеке), и запомнить выделенный регистр в словаре. Всякий раз, когда встречается ссылка на имя переменной, используя имя переменной в качестве ключа можно найти имя соответствующего регистра.
3.5 Оптимизация
Если говорить о компиляторе языка C, то ассемблерный код получается сложнее, чем описано выше. В действительности компилятор производит сначала некоторый промежуточный код, затем этот код оптимизируется и, наконец, создается окончательный вариант ассемблерного кода.
Тема оптимизации кода слишком обширна, чтобы обсуждать ее здесь, поэтому остановимся лишь на самом простом методе оптимизации - локальная оптимизация [peephole optimization]. Простейший способ выполнения локальной оптимизации -- написать участок кода на языке ассемблера вручную и сравнить его с кодом, создаваемым вашим компилятором.
Например, если в имеющемся наборе отсутствует инструкция умножения, то вы можете заставить компилятор производить код, выполняющий умножение, через последовательность сложений. В качестве оптимизации можно предложить проверять величину операндов, и если один из них равен 1, то в качестве результата можно сразу принять второй операнд, минуя цикл сложений. Далее, поскольку величина множителя (количество значимых бит прим. перев.) определяет количество итераций, в качестве множителя можно назначать меньший из операндов.
Еще один пример локальной оптимизации -- оптимизация безусловных переходов:
jmp .L1 . . . . . .L1 jmp .L2 . . . . . .L2 add ax,bx
В этом случае, число выполняемых инструкций безусловного перехода можно сократить, изменив первую команду jump :
jmp .L2 . . . . . .L1 jmp .L2 . . . . . .L2 add ax,bx
Существуют различные алгоритмы оптимизации. Методы, описанные выше, являются лишь первым маленьким шагом в направлении оптимизации по времени исполнения и размеру создаваемого кода.
4. Что дальше?
Примеры, приведенные выше, не являются полнофункциональным компилятором. Для их завершения требуется реализовать гораздо большее число привычных конструкций. Эти примеры можно рассматривать лишь как иллюстрацию написания соответствующих этим привычным конструкциям правил, регулярных выражений (для выделения лексем), функций грамматического разбора и функций реализации семантики языка.
Dinil Divakaran
Я -- студент последнего года по специальности "Информатика" [computer science] в колледже GEC Thrissur в Керале, Индия.
Copyright (C) 2002, Dinil Divakaran.
Простой интерпретатор с нуля на Python (перевод) #1
Вещь, которая привлекла меня изучать компьютерную науку была компилятором. Я думал, что это все магия, как они могут читать даже мой плохо написанный код и компилировать его. Когда я прошел курс компиляторов, я стал находить этот процесс очень простым и понятным.
Содержание
В этом цикле статей я попытаюсь захватить часть этой простоты путем написания простого интерпретатора для обычного императивного языка IMP (IMperative Language). Интерпретатор будет написан на Питоне, потому что это простой и широко известный язык. Также, питон-код похож на псевдокод, и даже если вы не знаете его [питон], у вас получится понять код. Парсинг будет выполнен с помощью простого набора комбинаторов, написанных с нуля (подробнее расскажу в следующей части). Никаких дополнительных библиотек не будет использовано, кроме sys (для I/O), re (регулярные выражения в лексере) и unittest (для проверки работоспособности нашей поделки).
Сущность языка IMP
Прежде всего, давайте обсудим, для чего мы будем писать интерпретатор. IMP есть нереально простой язык со следующими конструкциями:
Присвоения (все переменные являются глобальные и принимают только integer):
x := 1
if x = 1 then y := 2 else y := 3 end
while x < 10 do x := x + 1 end
Составные операторы (разделенные ;):
x := 1; y := 2
Это всего-лишь игрушечный язык. Но вы можете расширить его до уровня полезности как у Python или Lua. Я лишь хотел сохранить его настолько простым, насколько смогу.
А вот тут пример программы, которая вычисляет факториал:
n := 5; p := 1; while n > 0 do p := p * n; n := n - 1 end
Язык IMP не умеет читать входные данные (input), т.е. в начале программы нужно создать все нужные переменные и присвоить им значения. Также, язык не умеет выводить что-либо: интерпретатор выведет результат в конце.
Структура интерпретатора
Ядро интерпретатора является ничем иным, как промежуточным представлением (intermediate representation, IR). Оно будет представлять наши IMP-программы в памяти. Так как IMP простой как 3 рубля, IR будет напрямую соответствовать синтаксису языка; мы создадим по классу для каждой единицы синтаксиса. Конечно, в более сложном языке вы хотели бы использовать еще и семантическую представление, которое намного легче для анализа или исполнения.
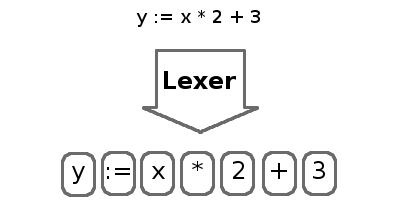
- Разобрать символы исходного кода на токены.
- Собрать все токены в абстрактное синтаксическое дерево (abstract syntax tree, AST). AST и есть наша IR.
- Исполнить AST и вывести результат в конце.
Процессом разделения символов на токены называется лексинг (lexing), а занимается этим лексер (lexer). Токены являют собой короткие, удобоваримые строки, содержащие самые основные части программы, такие как числа, идентификаторы, ключевые слова и операторы. Лексер будет пропускать пробелы и комментарии, так как они игнорируются интерпретатором.
Процесс сборки токенов в AST называется парсингом. Парсер извлекает структуру нашей программы в форму, которую мы можем исполнить.
Эта статься будет сосредоточена исключительно на лексере. Сначала мы напишем общую лекс-библиотеку а затем уже лексер для IMP. Следующие части будут сфокусированы на парсере и исполнителе.
Лексер
По правде говоря, лексические операции очень просты и основываются на регулярных выражениях. Если вы с ними не знакомы, то можете прочитать официальную документацию.
Входными данными для лексера будет простой поток символов. Для простоты мы прочитаем инпут в память. А вот выходящими данными будет список токенов. Каждый токен включает в себя значение и метку (тег, для идентификации вида токена). Парсер будет использовать это для построения дерева (AST).
Итак, давайте сделаем обычнейший лексер, который будет брать список регэкспов и разбирать на теги код. Для каждого выражения он будет проверять, соответствует ли инпут текущей позиции. Если совпадение найдено, то соответствующий текст извлекается в токен, наряду с тегом регулярного выражения. Если регулярное выражение ни к чему не подходит, то текст отбрасывается. Это позволяет нам избавиться от таких вещей как комментарии и пробелы. Если вообще ничего не совпало, то мы рапортуем об ошибке и скрипт становится героем. Этот процесс повторяется, пока мы не разберем весь поток кода.
Вот код из библиотеки лексера:
import sys import re def lex(characters, token_exprs): pos = 0 tokens = [] while pos < len(characters): match = None for token_expr in token_exprs: pattern, tag = token_expr regex = re.compile(pattern) match = regex.match(characters, pos) if match: text = match.group(0) if tag: token = (text, tag) tokens.append(token) break if not match: sys.stderr.write('Illegal character: %s\n' % characters[pos]) sys.exit(1) else: pos = match.end(0) return tokens Отметим, что порядок передачи в регулярные выражения является значительным. Функция lex будет перебирать все выражения и примет только первое найденное совпадение. Это значит, что при использовании этой функции, первым делом нам следует передавать специфичные выражения (соответствующие операторам и ключевым словам), а затем уже обычные выражения (идентификаторы и числа).
Лексер IMP
С учетом кода выше, создание лексера для нашего языка становится очень простым. Для начала определим серию тегов для токенов. Для языка нужно всего лишь 3 тега. RESERVED для зарезервированных слов или операторов, INT для чисел, ID для идентификаторов.
import lexer RESERVED = 'RESERVED' INT = 'INT' ID = 'ID' Теперь мы определим выражения для токенов, которые будут использованы в лексере. Первые два выражения соответствуют пробелам и комментариям. Так как у них нету тегов, лексер их пропустит.
token_exprs = [ (r'[ \n\t]+', None), (r'#[^\n]*', None), После этого следуют все наши операторы и зарезервированные слова.
(r'\:=', RESERVED), (r'\(', RESERVED), (r'\)', RESERVED), (r';', RESERVED), (r'\+', RESERVED), (r'-', RESERVED), (r'\*', RESERVED), (r'/', RESERVED), (r'=', RESERVED), (r'>', RESERVED), (r'=', RESERVED), (r'!=', RESERVED), (r'and', RESERVED), (r'or', RESERVED), (r'not', RESERVED), (r'if', RESERVED), (r'then', RESERVED), (r'else', RESERVED), (r'while', RESERVED), (r'do', RESERVED), (r'end', RESERVED),
Наконец, нам нужны выражения для чисел и идентификаторов. Обратите внимание, что регулярным выражениям для идентификаторов будут соответствовать все зарезервированные слова выше, поэтому очень важно, чтобы эти две строчки шли последними.
(r'[0-9]+', INT), (r'[A-Za-z][A-Za-z0-9_]*', ID), ]
Когда наши регэкспы определены, мы можем создать обертку над функцией lex:
def imp_lex(characters): return lexer.lex(characters, token_exprs) Если вы дочитали до этих слов, то вам, скорее всего, будет интересно как работает наше чудо. Вот код для теста:
import sys from imp_lexer import * if __name__ == '__main__': filename = sys.argv[1] file = open(filename) characters = file.read() file.close() tokens = imp_lex(characters) for token in tokens: print token $ python imp.py hello.impСкачать полный исходный код: imp-interpreter.tar.gz
Автор оригинальной статьи — Jay Conrod.
UPD: Спасибо пользователю zeLark за исправление бага, связанного с порядком определения шаблонов.
Python Lex-Yacc
Чтобы установить PLY на вашем компьютере для python2 / 3, выполните действия, описанные ниже:
- Скачать исходный код здесь .
- Распакуйте загруженный zip-файл
- Перейдите в распакованный ply-3.10 папку
- Выполните следующую команду в терминале: python setup.py install
Если вы выполнили все вышеперечисленное, теперь вы сможете использовать модуль PLY. Вы можете проверить это, открыв интерпретатор питона и набрав import ply.lex .
Примечание: Не используйте pip установить PLY, он установит битый дистрибутив на вашей машине.
"Привет, мир!" PLY - простой калькулятор
Давайте продемонстрируем силу PLY на простом примере: эта программа примет арифметическое выражение в качестве строкового ввода и попытается его решить.
Откройте ваш любимый редактор и скопируйте следующий код:
from ply import lex import ply.yacc as yacc tokens = ( 'PLUS', 'MINUS', 'TIMES', 'DIV', 'LPAREN', 'RPAREN', 'NUMBER', ) t_ignore = '\t' t_PLUS = r'\+' t_MINUS = r'-' t_TIMES = r'\*' t_DIV = r'/' t_LPAREN = r'\(' t_RPAREN = r'\)' def t_NUMBER( t ) : r'[0-9]+' t.value = int( t.value ) return t def t_newline( t ): r'\n+' t.lexer.lineno += len( t.value ) def t_error( t ): print("Invalid Token:",t.value[0]) t.lexer.skip( 1 ) lexer = lex.lex() precedence = ( ( 'left', 'PLUS', 'MINUS' ), ( 'left', 'TIMES', 'DIV' ), ( 'nonassoc', 'UMINUS' ) ) def p_add( p ) : 'expr : expr PLUS expr' p[0] = p[1] + p[3] def p_sub( p ) : 'expr : expr MINUS expr' p[0] = p[1] - p[3] def p_expr2uminus( p ) : 'expr : MINUS expr %prec UMINUS' p[0] = - p[2] def p_mult_div( p ) : '''expr : expr TIMES expr | expr DIV expr''' if p[2] == '*' : p[0] = p[1] * p[3] else : if p[3] == 0 : print("Can't divide by 0") raise ZeroDivisionError('integer division by 0') p[0] = p[1] / p[3] def p_expr2NUM( p ) : 'expr : NUMBER' p[0] = p[1] def p_parens( p ) : 'expr : LPAREN expr RPAREN' p[0] = p[2] def p_error( p ): print("Syntax error in input!") parser = yacc.yacc() res = parser.parse("-4*-(3-5)") # the input print(res) Сохраните этот файл как calc.py и запустить его.
Какой правильный ответ на -4 * - (3 - 5) .
Часть 1: токенизация ввода с помощью Lex
Есть два шага , что код , полученный в примере 1 , осуществляется: один был tokenizing входа, который означает , что он искал символы , которые представляют собой арифметическое выражение, а второй шаг синтаксического анализа, который включает в себя анализ извлеченных маркеров и оценку результата.
В этом разделе приводится простой пример того , как разметить пользовательского ввода, а затем разбивает его построчно.
import ply.lex as lex # List of token names. This is always required tokens = [ 'NUMBER', 'PLUS', 'MINUS', 'TIMES', 'DIVIDE', 'LPAREN', 'RPAREN', ] # Regular expression rules for simple tokens t_PLUS = r'\+' t_MINUS = r'-' t_TIMES = r'\*' t_DIVIDE = r'/' t_LPAREN = r'\(' t_RPAREN = r'\)' # A regular expression rule with some action code def t_NUMBER(t): r'\d+' t.value = int(t.value) return t # Define a rule so we can track line numbers def t_newline(t): r'\n+' t.lexer.lineno += len(t.value) # A string containing ignored characters (spaces and tabs) t_ignore = '\t' # Error handling rule def t_error(t): print("Illegal character '%s'" % t.value[0]) t.lexer.skip(1) # Build the lexer lexer = lex.lex() # Give the lexer some input lexer.input(data) # Tokenize while True: tok = lexer.token() if not tok: break # No more input print(tok)
Сохраните этот файл как calclex.py .Мы будем использовать это при создании нашего парсера Yacc.
Сломать
- Импорт модуля с помощью import ply.lex
Все лексеры должны предоставить список под названием tokens , который определяет все возможные имена лексем , которые могут быть получены лексером. Этот список всегда обязателен.
tokens = [ 'NUMBER', 'PLUS', 'MINUS', 'TIMES', 'DIVIDE', 'LPAREN', 'RPAREN', ]
tokens также могут быть кортеж строк (а не строка), где каждая строка обозначает маркер , как и раньше.
Правило регулярного выражения для каждой строки может быть определено либо как строка, либо как функция. В любом случае, перед именем переменной должен стоять префикс t_, чтобы обозначить, что это правило для сопоставления токенов.
- Для простых лексем, регулярное выражение может быть задано в виде строки: t_PLUS = r'\+'
Построить лексер используя lexer = lex.lex() .
## Вы также можете поместить все в класс и вызвать экземпляр класса, чтобы определить лексер. Например:
import ply.lex as lex class MyLexer(object): . # everything relating to token rules and error handling comes here as usual # Build the lexer def build(self, **kwargs): self.lexer = lex.lex(module=self, **kwargs) def test(self, data): self.lexer.input(data) for token in self.lexer.token(): print(token) # Build the lexer and try it out m = MyLexer() m.build() # Build the lexer m.test("3 + 4") #
Обеспечить ввод с помощью lexer.input(data) , где данные является строкой
Для того, чтобы получить маркеры, используйте lexer.token() , который возвращает лексемы совпавшие. Вы можете перебрать лексер в цикле, как в:
ибо я в лексере:
print(i)
Часть 2: парсинг токенизированного ввода с помощью Yacc
В этом разделе объясняется, как обрабатывается входной токен из части 1 - это делается с помощью контекстно-свободных грамматик (CFG). Грамматика должна быть указана, а токены обрабатываются в соответствии с грамматикой. Под капотом парсер использует LALR-парсер.
# Yacc example import ply.yacc as yacc # Get the token map from the lexer. This is required. from calclex import tokens def p_expression_plus(p): 'expression : expression PLUS term' p[0] = p[1] + p[3] def p_expression_minus(p): 'expression : expression MINUS term' p[0] = p[1] - p[3] def p_expression_term(p): 'expression : term' p[0] = p[1] def p_term_times(p): 'term : term TIMES factor' p[0] = p[1] * p[3] def p_term_div(p): 'term : term DIVIDE factor' p[0] = p[1] / p[3] def p_term_factor(p): 'term : factor' p[0] = p[1] def p_factor_num(p): 'factor : NUMBER' p[0] = p[1] def p_factor_expr(p): 'factor : LPAREN expression RPAREN' p[0] = p[2] # Error rule for syntax errors def p_error(p): print("Syntax error in input!") # Build the parser parser = yacc.yacc() while True: try: s = raw_input('calc >') except EOFError: break if not s: continue result = parser.parse(s) print(result) Сломать
Каждое правило грамматики определяется функцией, в которой строка документации для этой функции содержит соответствующую контекстно-независимую грамматическую спецификацию. Операторы, составляющие тело функции, реализуют семантические действия правила. Каждая функция принимает один аргумент p, который представляет собой последовательность, содержащую значения каждого грамматического символа в соответствующем правиле. Значения p[i] сопоставляются грамматические символы , как показано здесь:
def p_expression_plus(p): 'expression : expression PLUS term' # ^ ^ ^ ^ # p[0] p[1] p[2] p[3] p[0] = p[1] + p[3]
- Для лексем, «ценность» соответствующий p[i] является таким же , как p.value атрибута , назначенным в модуле лексического анализатора. Таким образом, PLUS будет иметь значение + .
Обратите внимание , что функция может иметь любое имя, до тех пор , как оно предваряется p_ .
- p_error(p) правило, определяется , чтобы поймать синтаксические ошибки ( такие же , как yyerror в YACC / зубров).
Несколько правил грамматики могут быть объединены в одну функцию, что является хорошей идеей, если производства имеют схожую структуру.
def p_binary_operators(p): '''expression : expression PLUS term | expression MINUS term term : term TIMES factor | term DIVIDE factor''' if p[2] == '+': p[0] = p[1] + p[3] elif p[2] == '-': p[0] = p[1] - p[3] elif p[2] == '*': p[0] = p[1] * p[3] elif p[2] == '/': p[0] = p[1] / p[3]
Символьные литералы могут использоваться вместо токенов.
def p_binary_operators(p): '''expression : expression '+' term | expression '-' term term : term '*' factor | term '/' factor''' if p[2] == '+': p[0] = p[1] + p[3] elif p[2] == '-': p[0] = p[1] - p[3] elif p[2] == '*': p[0] = p[1] * p[3] elif p[2] == '/': p[0] = p[1] / p[3]
Конечно, литералы должны быть указаны в модуле lexer.
- Чтобы явно задать начальный символ, используйте start = 'foo' , где foo некоторая нетерминал.
Установка приоритета и ассоциативности может быть выполнена с помощью переменной приоритета.
precedence = ( ('nonassoc', 'LESSTHAN', 'GREATERTHAN'), # Nonassociative operators ('left', 'PLUS', 'MINUS'), ('left', 'TIMES', 'DIVIDE'), ('right', 'UMINUS'), # Unary minus operator )
Жетоны упорядочены по возрастанию. nonassoc означает , что эти маркеры не ассоциируют. Это значит , что - то вроде a < b < c незаконна тогда a < b по - прежнему законно.