Как заполнить список длиной N числами от 1 до N?
Как можно сделать, что бы список заполнялся от 1 до N числа. К примеру, я ввожу число 10, и нужно, чтобы ответ вывелся так 1 2 3 4 5 6 7 8 9 10.
Отслеживать
13.8k 12 12 золотых знаков 43 43 серебряных знака 76 76 бронзовых знаков
задан 9 окт 2018 в 10:44
MISHAEL OVECHKIN MISHAEL OVECHKIN
43 1 1 золотой знак 2 2 серебряных знака 8 8 бронзовых знаков
3 ответа 3
Сортировка: Сброс на вариант по умолчанию
Для формирования списка нужного размера можно использовать функцию range
N = int(input("Введите размер списка: ")) spam = list(range(1, N+1)) print(spam) > Введите размер списка: 10 > [1, 2, 3, 4, 5, 6, 7, 8, 9, 10] Отслеживать
ответ дан 9 окт 2018 в 10:49
Alexshev92 Alexshev92
3,135 6 6 золотых знаков 18 18 серебряных знаков 34 34 бронзовых знака
9 окт 2018 в 10:58
В python-2.x достаточно следующего кода:
N = 3 print range(1, N + 1) # [1, 2, 3] N = 3 print " ".join(map(str, range(1, N + 1))) # 1 2 3 В python-3.x схема работы range изменена, напрямую возвращает класс, поэтому чтобы вывести список принудительно проводим через list :
print(list(range(1, N+1))) # [1, 2, 3] print(" ".join(map(str, range(1, N+1)))) # 1 2 3 Артём Санников
Данная книга является руководством для начинающих специалистов в области анализа и обработки данных. В книге рассматривается язык SQL и его процедурное расширение PL/SQL от компании Oracle.
SQL без слёз
Цель книги заключается в том, чтобы научить любого человека работать с реляционными базами данных и получать из них необходимую информацию посредством выполнения SQL-запросов.
Главная › Языки программирования › Python › Списки › Создание числового списка при помощи range() в Python
Создание числового списка при помощи range() в Python
Чтобы создать числовой список в Python, необходимо преобразовать результаты функции range() в список при помощи функции list() . Если заключить вызов функции range() в list() , то результат будет представлять собой список с числами.
Обратите внимание: функция range() создаёт числовую последовательность в указанном диапазоне, и выводит число с явлением «смещение на 1». Если вы укажете .range(1,5) , то функция выведет вам числа от 1 до 4.
# Создание числового списка при помощи list() и range() numbers = list(range(1,10)) # Выводим список на экран print(numbers) # Финальный результат в консоли [1, 2, 3, 4, 5, 6, 7, 8, 9]
Записи по теме
- Проверка отсутствия значения в списке Python
- Проверка вхождения значения в список Python
- Копирование списка в Python
- Перебор содержимого среза списка в Python
- Срез для списка в Python
- Генератор списков в Python
- Перебор всего списка в Python
- Определение длины списка в Python
Массивы
Часто в программах бывает надо работать с большим количество однотипных переменных. Например, пусть вам надо записать рост каждого человека в классе — это много целых чисел. Вы можете завести по одной переменной на каждого ученика, но это очень не удобно. Специально для этого придуманы массивы.
Общее представление о массиве
Массив (в питоне еще принято название «список», это то же самое) — это переменная, в которой хранится много значений. Массив можно представлять себе в виде такой последовательности ячеек, в каждой из которых записано какое-то число:
Соответственно, переменная теперь может хранить целиком такой массив. Создается такой массив, например, путем перечисления значений в квадратных скобках:
a = [7, 5, -3, 12, 2, 0]
Теперь переменная a хранит этот массив. К элементам массива можно обращаться тоже через квадратные скобки: a[2] — это элемент номер 2, т.е. в нашем случае это -3 . Аналогично, a[5] — это 0. В квадратных скобках можно использовать любые арифметические выражения и даже другие переменные: a[2*2-1] — это 12, a[i] обозначает «возьми элемент с номером, равным значению переменной i «, аналогично a[2*i+1] обозначает «возьми элемент с номером, равным 2*i+1», или даже a[a[4]] обозначает «возьми элемент с номером, равным четвертому элементу нашего массива» (в нашем примере a[4] — это 2 , поэтому a[a[4]] — это a[2] , т.е. -3 ).
Если указанный номер слишком большой (больше длины массива), то питон выдаст ошибку (т.е. в примере выше a[100] будет ошибкой, да и даже a[6] тоже). Если указан отрицательный номер, то тут действует хитрое правило. Отрицательные номера обозначают нумерацию массива с конца: a[-1] — это всегда последний элемент, a[-2] — предпоследний и т.д. В нашем примере a[-6] равно 7. Слишком большой отрицательный номер тоже дает ошибку (в нашем примере a[-7] уже ошибка).
С элементами массива можно работать как с привычными вам переменными. Можно им присваивать значения: a[3] = 10 , считывать с клавиатуры: a[3] = int(input()) , выводить на экран: print(a[3]) , использовать в выражениях: a[3+i*a[2]] = 3+abs(a[1]-a[0]*2+i) (здесь i — какая-то еще целочисленная переменная для примера), использовать в if’ах: if a[i]>a[i-2]: , или for a[2] in range(i) и т.д. Везде, где вы раньше использовали переменные, можно теперь использовать элемент массива.
Обход массива
Но обычно вам надо работать сразу со всеми элементами массива. Точнее, сразу со всеми как правило не надо, надо по очереди с каждым (говорят: «пробежаться по массиву»). Для этого вам очень полезная вещь — это цикл for . Если вы знаете, что в массиве n элементов (т.е. если у вас есть переменная n и в ней хранится число элементов в массиве), то это делается так:
for i in range(n): . что-то сделать с элементом a[i]
например, вывести все элементы массива на экран:
for i in range(n): print(a[i])
или увеличить все элементы массива на единицу:
for i in range(n): a[i] += 1
и т.п. Конечно, в цикле можно и несколько действий делать, если надо. Осознайте, что это не магия, а просто полностью соответствует тому, что вы знаете про работу цикла for.
Если же у вас нет переменной n , то вы всегда можете воспользоваться специальной функцией len , которая возвращает количество элементов в массиве:
for i in range(len(a)): .
Функцию len , конечно, можно использовать где угодно, не только в заголовке цикла. Например, просто вывести длину массива — print(len(a)) .
Операции на массиве
Еще ряд полезных операций с массивами:
- a[i] (на всякий случай повторю, чтобы было легче найти) — элемент массива с номером i .
- len(a) (на всякий случай повторю, чтобы было легче найти) — длина массива.
- a.append(x) — приписывает к массиву новый элемент со значением x , в результате длина массива становится на 1 больше. Конечно, вместо x может быть любое арифметическое выражение.
- a.pop() — симметричная операция, удаляет последний элемент из массива. Длина массива становится на 1 меньше. Если нужно запомнить значение удаленного элемента, надо просто сохранить результат вызова pop в новую переменную: res = a.pop() .
- a * 3 — это массив, полученный приписыванием массива a самого к себе три раза. Например, [1, 2, 3] * 3 — это [1, 2, 3, 1, 2, 3, 1, 2, 3] . Конечно, на месте тройки тут может быть любое арифметическое выражение. Самое частое применение этой конструкции — если вам нужен массив длины n , заполненный, например, нулями, то вы пишете [0] * n .
- b = a — присваивание массивов. Теперь в b записан тот же массив, что и в a . Тот же — в прямом смысле слова: теперь и a , и b соответствуют одному и тому же массиву, и изменения в b отразятся в a и наоборот. Еще раз, потому что это очень важно. Присваивание массивов (и вообще любых сложных объектов) в питоне не копирует массив, а просто обе переменные начинают ссылаться на один и тот же массив, и изменения массива через любую из них меняет один и тот же массив. При этом на самом деле тут есть многие тонкости, просто будьте готовы к неожиданностям.
- b = a[1:4] («срез») — делает новый массив, состоящий из элементов старого массива начиная со первого (помните про нумерацию с нуля!) и заканчивая третьим (т.е. до четвертого, но не включительно, аналогично тому, как работает range ); этот массив сохраняется в b . Для примера выше получится [5, -3, 12] . Конечно, на месте 1 и 4 может быть любое арифметическое выражение. Более того, эти индексы можно вообще не писать, при этом автоматически подразумевается начало и конец массива. Например, a[:3] — это первые три элемента массива (нулевой, первый и второй), a[1:] — все элементы кроме нулевого, a[:-1] — все элементы кроме последнего (!), а a[:] — это копия всего массива. И это именно копия, т.е. запись b = a[:] именно копирует массив, получающиеся массивы никак не связаны, и изменения в b не влияют на a (в отличие от b = a ).
Ввод-вывод массива
Как вам считывать массив? Во-первых, если все элементы массива задаются в одной строке входного файла. Тогда есть два способа. Первый — длинный, но довольно понятный:
a = input().split() # считали строку и разбили ее по пробелам # получился уже массив, но питон пока не понимает, что в массиве числа for i in range(len(a)): a[i] = int(a[i]) # прошли по всем элементам массива и превратили их в числа
Второй — покороче, но попахивает магией:
a = list(map(int, input().split()))
Может показаться страшно, но на самом деле map(int, input().split()) вы уже встречали в конструкции
x, y = map(int, input().split())
когда вам надо было считать два числа из одной строки. Это считывает строку ( input() ), разбивает по пробелам ( .split() ), и превращает каждую строку в число ( map(int, . ) ). Для чтения массива все то же самое, только вы еще заворачиваете все это в list(. ) , чтобы явно сказать питону, что это массив.
Какой из этих двух способов использовать для чтения данных из одной строки — выбирать вам.
Обратите внимание, что в обоих способах вам не надо знать заранее, сколько элементов будет в массиве — получится столько, сколько чисел в строке. В задачах часто бывает что задается сначала количество элементов, а потом (обычно на следующей строке) сами элементы. Это удобно в паскале, c++ и т.п., где нет способа легко считать числа до конца строки; в питоне вам это не надо, вы легко считываете сразу все элементы массива до конца строки, поэтому заданное число элементов вы считываете, но дальше не используете:
n = int(input()) # больше n не используем a = list(map(int, input().split()))
Еще бывает, что числа для массива задаются по одному в строке. Тогда вам проще всего заранее знать, сколько будет вводиться чисел. Обычно как раз так данные и даются: сначала количество элементов, потом сами элементы. Тогда все вводится легко:
n = int(input()) a = [] # пустой массив, т.е. массив длины 0 for i in range(n): a.append(int(input())) # считали число и сразу добавили в конец массива
Более сложные варианты — последовательность элементов по одному в строке, заканчивающаяся нулем, или задано количество элементов и сами элементы в той же строке — придумайте сами, как сделать (можете подумать сейчас, можете потом, когда попадется в задаче). Вы уже знаете все, что для этого надо.
Как выводить массив? Если надо по одному числу в строку, то просто:
for i in range(len(a)): print(a[i])
Если же надо все числа в одну строку, то есть два способа. Во-первых, можно команде print передать специальный параметр end=» » , который обозначает «заканчивать вывод пробелом (а не переводом строки)»:
for i in range(len(a)): print(a[i], end=" ")
Есть другой, более простой способ:
print(*a)
Эта магия обозначает вот что: возьми все элементы массива a и передай их отдельными аргументами в одну команду print . Т.е. получается print(a[0], a[1], a[2], . ) .
Двумерные массивы
Выше везде элементами массива были числа. Но на самом деле элементами массива может быть что угодно, в том числе другие массивы. Пример:
a = [10, 20, 30] b = [-1, -2, -3] c = [100, 200] z = [a, b, c]
Что здесь происходит? Создаются три обычных массива a , b и c , а потом создается массив z , элементами которого являются как раз массивы a , b и c .
Что теперь получается? Например, z[1] — это элемент №1 массива z , т.е. b . Но b — это тоже массив, поэтому я могу написать z[1][2] — это то же самое, что b[2] , т.е. -3 (не забывайте, что нумерация элементов массива идет с нуля). Аналогично, z[0][2]==30 и т.д.
То же самое можно было записать проще:
z = [[10, 20, 30], [-1, -2, -3], [100, 200]]
Получилось то, что называется двумерным массивом. Его можно себе еще представить в виде любой из этих двух табличек:
z содержит три элемента, и не важно, что каждый из них тоже массив), а len(z[2]) — длина внутреннего массива на позиции 2 (т.е. 2 в примере выше). Для массива x выше (того, у которого каждый подмассив имеет свою длину) получим len(x)==5 , и, например, len(x[3])==0 .
Аналогично работают все остальные операции. z.append([1,2]) приписывает к «внешнему» массиву еще один «внутренний» массив, а z[2].append(3) приписывает число 3 к тому «внутреннему» массиву, который находится на позиции 2. Далее, z.pop() удаляет последний «внутренний» из «внешнего» массива, а z[2].pop() удаляет последний элемент из «внутреннего» массива на позиции 2. Аналогично работают z[1:2] и z[1][0:1] и т.д. — все операции, которые я приводил выше.
Обход двумерного массива
Конечно, чтобы обойти двумерный массив, надо обойти каждый его «внутренний» массив. Чтобы обойти внутренний массив, нужен цикл for , и еще один for нужен, чтобы перебрать все внутренние массивы:
for i in range(len(z)): # будем теперь обходить массив z[i] for j in range(len(z[i])): . что-то сделаем с элементом z[i][j]
Создание пустого массива
Неожиданно нетривиальная операция на двумерных массивах — это создание двумерного массива определенного размера, заполненного, например, нулями. Вы помните, что одномерный массив длины n можно создавать как [0] * n . Возникает желание написать a = ([0] * m) * n , чтобы создать двумерный массив размера n x m (мы хотим, чтобы первый индекс массива менялся от 0 до n-1 , а второй индекс до m-1 , поэтому это именно ([0] * m) * n , а не ([0] * n) * m ). Но это сработает не так, как вы можете думать. Дело опять в том, что в питоне массивы по умолчанию не копируются полностью, поэтому то, что получается — это массив длина n , в котором каждый элемент соответствует одному и тому же массиву длины n . В итоге, если вы будете менять, например, a[1][2] , то так же будет меняться и a[0][2] , и a[3][2] и т.д. — т.к. все внутренние массивы на самом деле соответствуют одному и тому же массиву.
Поэтому массив размера n x m делается, например, так:
a = [] for i in range(n): a.append([0] * m)
мы вручную n раз приписали к массиву a один и тот же массив.
Или еще есть магия в одну строчку:
a = [[0] * m for i in range(n)]
Я пока не буду объяснять, как это работает, просто можете запомнить. Или пользоваться предыдущим вариантом.
Обратите внимание, что тут важный момент — хотим мы, чтобы n соответствовало первому индексу или второму. В примерах выше n — размер первого индекса (т.е. размер «внешнего» массива), a m — размер второго индекса (т.е. размер каждого «внутреннего» массива). Если вы хотите, то можно делать и наоборот, но это вы сами должны решить и делать согласованно во всей программе.
Ввод-вывод двумерного массива
Обычно двумерный массив вам задается как n строк по m чисел в каждой, причем числа n и m вам задаются заранее. Такой двумерный массив вводится эдакой комбинацией двух способов ввода одномерного массива, про которые я писал выше:
n, m = map(int, input().split()) # считали n и m из одной строки # m дальше не будет нужно a = [] for i in range(n): a.append(list(map(int, input().split())))
Мы считываем очередную строку и получаем очередной «внутренний» массив: list(map(int, input().split())) , и приписываем его ( append ) ко внешнему массиву.
Обратите внимание, что здесь мы уже четко решили, что первый индекс нашего массива соответствует строкам входного файла, а второй индекс — столбцам, т.е. фактически мы уже выбрали левую из двух картинок выше. Но это связано не с тем, как питон работает с двумерными массивами, а с тем, как заданы входные данные во входном файле.
Вывод двумерного массива, если вам его надо вывести такой же табличкой, тоже делается комбинацией способов вывода одномерного массива, например, так:
for i in range(len(a)): print(*a[i])
for i in range(len(a)): for j in range(len(a[i])): print(a[i][j], end=" ") print() # сделать перевод строки
Многомерные массивы
Аналогично двумерным, бывают и трехмерные и т.д. массивы. Просто каждый элемент «внутреннего» массива теперь сам будет массивом:
a = [[[1, 2], [3, 4]], [[5, 6], [7, 8]]]
Здесь a[0] — это двумерный массив [[1, 2], [3, 4]] , и a[1] — двумерный массив [[5, 6], [7, 8]] . Например, a[1][0][1] == 6 .
Многомерные массивы в простых задачах не нужны, но на самом деле бывают полезны и не представляют из себя чего-то особо сложного. С ними все аналогично тому, что мы обсуждали про двумерные массивы.
NumPy: матрицы и операции над ними
В этом ноутбуке из сторонних библиотек нам понадобится только NumPy. Для удобства импортируем ее под более коротким именем:
import numpy as np
1. Создание матриц
Приведем несколько способов создания матриц в NumPy.
Самый простой способ — с помощью функции numpy.array(list, dtype=None, . ).
В качестве первого аргумента ей надо передать итерируемый объект, элементами которого являются другие итерируемые объекты одинаковой длины и содержащие данные одинакового типа.
Второй аргумент является опциональным и определяет тип данных матрицы. Его можно не задавать, тогда тип данных будет определен из типа элементов первого аргумента. При задании этого параметра будет произведена попытка приведения типов.
Например, матрицу из списка списков целых чисел можно создать следующим образом:
a = np.array([1, 2, 3]) # Создаем одномерный массив print(type(a)) # Prints "" print(a.shape) # Prints "(3,)" - кортеж с размерностями print(a[0], a[1], a[2]) # Prints "1 2 3" a[0] = 5 # Изменяем значение элемента массива print(a) # Prints "[5, 2, 3]" b = np.array([[1,2,3],[4,5,6]]) # Создаем двухмерный массив print(b.shape) # Prints "(2, 3)" print(b[0, 0], b[0, 1], b[1, 0]) # Prints "1 2 4" print(np.arange(1, 5)) #Cоздает вектор с эелементами от 1 до 4
(3,) 1 2 3 [5 2 3] (2, 3) 1 2 4 [1 2 3 4]
matrix = np.array([[1, 2, 3], [2, 5, 6], [6, 7, 4]]) print ("Матрица:\n", matrix)
Матрица: [[1 2 3] [2 5 6] [6 7 4]]
Второй способ создания — с помощью встроенных функций numpy.eye(N, M=None, . ), numpy.zeros(shape, . ), numpy.ones(shape, . ).
Первая функция создает единичную матрицу размера N×M ; если M не задан, то M = N .
Вторая и третья функции создают матрицы, состоящие целиком из нулей или единиц соответственно. В качестве первого аргумента необходимо задать размерность массива — кортеж целых чисел. В двумерном случае это набор из двух чисел: количество строк и столбцов матрицы.
Примеры:
b = np.eye(5) print ("Единичная матрица:\n", b)
Единичная матрица: [[1. 0. 0. 0. 0.] [0. 1. 0. 0. 0.] [0. 0. 1. 0. 0.] [0. 0. 0. 1. 0.] [0. 0. 0. 0. 1.]]
c = np.ones((7, 5)) print ("Матрица, состоящая из одних единиц:\n", c)
Матрица, состоящая из одних единиц: [[1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.] [1. 1. 1. 1. 1.]]
d = np.full((2,2), 7) # Создает матрицу (1, 2) заполненую заданным значением print(d) # Prints "[[ 7. 7.] # [ 7. 7.]]" e = np.random.random((2,2)) # Создает еденичную матрицу (2, 2) заполненую случаными числами (0, 1) print(e) # Might print "[[ 0.91940167 0.08143941] # [ 0.68744134 0.87236687]]"
[[7 7] [7 7]] [[0.25744383 0.48056466] [0.13767881 0.40578168]]
Обратите внимание: размерность массива задается не двумя аргументами функции, а одним — кортежем!
Вот так — np.ones(7, 5) — создать массив не получится, так как функции в качестве параметра shape передается 7, а не кортеж (7, 5).
И, наконец, третий способ — с помощью функции numpy.arange([start, ]stop, [step, ], . ), которая создает одномерный массив последовательных чисел из промежутка [start, stop) с заданным шагом step, и метода array.reshape(shape).
Параметр shape, как и в предыдущем примере, задает размерность матрицы (кортеж чисел). Логика работы метода ясна из следующего примера:
v = np.arange(0, 24, 2) print ("Вектор-столбец:\n", v)
Вектор-столбец: [ 0 2 4 6 8 10 12 14 16 18 20 22]
d = v.reshape((3, 4)) print ("Матрица:\n", d)
Матрица: [[ 0 2 4 6] [ 8 10 12 14] [16 18 20 22]]
Более подробно о том, как создавать массивы в NumPy, см. документацию.
2. Индексирование
Для получения элементов матрицы можно использовать несколько способов. Рассмотрим самые простые из них.
Для удобства напомним, как выглядит матрица d:
print ("Матрица:\n", d)
Матрица: [[ 0 2 4 6] [ 8 10 12 14] [16 18 20 22]]
Элемент на пересечении строки i и столбца j можно получить с помощью выражения array[i, j].
Обратите внимание: строки и столбцы нумеруются с нуля!
print ("Второй элемент третьей строки матрицы:", d[2, 1])
Второй элемент третьей строки матрицы: 18
Из матрицы можно получать целые строки или столбцы с помощью выражений array[i, :] или array[:, j] соответственно:
print ("Вторая строка матрицы d:\n", d[1, :]) print ("Четвертый столбец матрицы d:\n", d[:, 3])
Вторая строка матрицы d: [ 8 10 12 14] Четвертый столбец матрицы d: [ 6 14 22]
Еще один способ получения элементов — с помощью выражения array[list1, list2], где list1, list2 — некоторые списки целых чисел. При такой адресации одновременно просматриваются оба списка и возвращаются элементы матрицы с соответствующими координатами. Следующий пример более понятно объясняет механизм работы такого индексирования:
print ("Элементы матрицы d с координатами (1, 2) и (0, 3):\n", d[[1, 0], [2, 3]])
Элементы матрицы d с координатами (1, 2) и (0, 3): [12 6]
# Slicing # Создадим матрицу (3, 4) # [[ 1 2 3 4] # [ 5 6 7 8] # [ 9 10 11 12]] a = np.array([[1,2,3,4], [5,6,7,8], [9,10,11,12]]) # Используя слайсинг, созадим матрицу b из элементов матрицы а # будем использовать 0 и 1 строку, а так же 1 и 2 столебц # [[2 3] # [6 7]] b = a[:2, 1:3] print(b) # ОБРАТИТЕ ВНИМАНИЕ НА ИЗМЕНЕНИЕ ИСХОДОЙ МАТРИЦЫ print(a[0, 1]) # Prints "2" b[0, 0] = 77 # b[0, 0] is the same piece of data as a[0, 1] print(a[0, 1]) # Prints "77"
[[2 3] [6 7]] 2 77
# Integer array indexing a = np.array([[1,2], [3, 4], [5, 6]]) print(a) print() # Пример Integer array indexing # В результате получится массив размерности (3,) # Обратите внимание, что до запятой идут индексы строк, после - столбцов print(a[[0, 1, 2], [0, 1, 0]]) # Prints "[1 4 5]" print() # По-другому пример можно записать так print(np.array([a[0, 0], a[1, 1], a[2, 0]])) # Prints "[1 4 5]"
[[1 2] [3 4] [5 6]] [1 4 5] [1 4 5]
Примеры использования слайсинга:
# Создадим новый маассив, из которого будем выбирать эллементы a = np.array([[1,2,3], [4,5,6], [7,8,9], [10, 11, 12]]) print(a) # prints "array([[ 1, 2, 3], # [ 4, 5, 6], # [ 7, 8, 9], # [10, 11, 12]])" # Создадим массив индексов b = np.array([0, 2, 0, 1]) # Выберем из каждой строки элемент с индексом из b (индекс столбца берется из b) print(a[np.arange(4), b]) # Prints "[ 1 6 7 11]" print() # Добавим к этим элементам 10 a[np.arange(4), b] += 10 print(a) # prints "array([[11, 2, 3], # [ 4, 5, 16], # [17, 8, 9], # [10, 21, 12]])
[[ 1 2 3] [ 4 5 6] [ 7 8 9] [10 11 12]] [ 1 6 7 11] [[11 2 3] [ 4 5 16] [17 8 9] [10 21 12]]
a = np.array([[1,2], [3, 4], [5, 6]]) bool_idx = (a > 2) # Найдем эллементы матрицы a, которые больше 2 # В результате получим матрицу b, такой же размерности, как и a print(bool_idx) # Prints "[[False False] print() # [ True True] # [ True True]]" # Воспользуемся полученным массивом для создания нового массива, ранга 1 print(a[bool_idx]) # Prints "[3 4 5 6]" # Аналогично print(a[a > 2]) # Prints "[3 4 5 6]"
[[False False] [ True True] [ True True]] [3 4 5 6] [3 4 5 6]
#Помните, что вы можете пользоваться сразу несколькими типами индексирования a = np.array([[1,2,3,4], [5,6,7,8], [9,10,11,12]]) row_r1 = a[1, :] row_r2 = a[1:2, :] print(row_r1, row_r1.shape) # Prints "[5 6 7 8] (4,)" print(row_r2, row_r2.shape) # Prints "[[5 6 7 8]] (1, 4)"
[5 6 7 8] (4,) [[5 6 7 8]] (1, 4)
Более подробно о различных способах индексирования в массивах см. документацию.
3. Векторы, вектор-строки и вектор-столбцы
Следующие два способа задания массива кажутся одинаковыми:
a = np.array([1, 2, 3]) b = np.array([[1], [2], [3]])
Однако, на самом деле, это задание одномерного массива (то есть вектора) и двумерного массива:
print ("Вектор:\n", a) print ("Его размерность:\n", a.shape) print ("Двумерный массив:\n", b) print ("Его размерность:\n", b.shape)
Вектор: [1 2 3] Его размерность: (3,) Двумерный массив: [[1] [2] [3]] Его размерность: (3, 1)
Обратите внимание: вектор (одномерный массив) и вектор-столбец или вектор-строка (двумерные массивы) являются различными объектами в NumPy, хотя математически задают один и тот же объект. В случае одномерного массива кортеж shape состоит из одного числа и имеет вид (n,), где n — длина вектора. В случае двумерных векторов в shape присутствует еще одна размерность, равная единице.
В большинстве случаев неважно, какое представление использовать, потому что часто срабатывает приведение типов. Но некоторые операции не работают для одномерных массивов. Например, транспонирование (о нем пойдет речь ниже):
a = a.T b = b.T
print ("Вектор не изменился:\n", a) print ("Его размерность также не изменилась:\n", a.shape) print ("Транспонированный двумерный массив:\n", b) print ("Его размерность изменилась:\n", b.shape)
Вектор не изменился: [1 2 3] Его размерность также не изменилась: (3,) Транспонированный двумерный массив: [[1 2 3]] Его размерность изменилась: (1, 3)
4. Datatypes
Все элементы в массиве numpy принадлежат одному типу. В этом плане массивы ближе к C, чем к привычным вам листам питона. Numpy имеет множество встренных типов, подходящих для решения большинства задач.
x = np.array([1, 2]) # Автоматический выбор типа print(x.dtype) # Prints "int64" x = np.array([1.0, 2.0]) # Автоматический выбор типа print(x.dtype) # Prints "float64" x = np.array([1, 2], dtype=np.int64) # Принудительное выставление типа print(x.dtype) # Prints "int64"
int32 float64 int64
5. Математические операции
К массивам (матрицам) можно применять известные вам математические операции. Следут понимать, что при этом у элементов должны быть схожие размерности. Поведение в случае не совпадения размерностей хорошо описанно в документации numpy.
x = np.array([[1,2],[3,4]], dtype=np.float64) y = np.array([[5,6],[7,8]], dtype=np.float64) arr = np.array([1, 2])
# Сложение происходит поэлеметно # [[ 6.0 8.0] # [10.0 12.0]] print(x + y) print() print(np.add(x, y)) print('С числом') print(x + 1) print('C массивом другой размерности') print(x + arr)
[[ 6. 8.] [10. 12.]] [[ 6. 8.] [10. 12.]] С числом [[2. 3.] [4. 5.]] C массивом другой размерности [[2. 4.] [4. 6.]]
# Вычитание print(x - y) print(np.subtract(x, y))
[[-4. -4.] [-4. -4.]] [[-4. -4.] [-4. -4.]]
# Деление # [[ 0.2 0.33333333] # [ 0.42857143 0.5 ]] print(x / y) print(np.divide(x, y))
[[0.2 0.33333333] [0.42857143 0.5 ]] [[0.2 0.33333333] [0.42857143 0.5 ]]
# Другие функции # [[ 1. 1.41421356] # [ 1.73205081 2. ]] print(np.sqrt(x))
[[1. 1.41421356] [1.73205081 2. ]]
6. Умножение матриц и столбцов
Напоминание теории. Операция умножения определена для двух матриц, таких что число столбцов первой равно числу строк второй.
Пусть матрицы A и B таковы, что A ∈ ℝ n×k и B ∈ ℝ k×m . Произведением матриц A и B называется матрица C , такая что cij = ∑ k r = 1 airbrj , где cij — элемент матрицы C , стоящий на пересечении строки с номером i и столбца с номером j .
В NumPy произведение матриц вычисляется с помощью функции numpy.dot(a, b, . ) или с помощью метода array1.dot(array2), где array1 и array2 — перемножаемые матрицы.
a = np.array([[1, 0], [0, 1]]) b = np.array([[4, 1], [2, 2]]) r1 = np.dot(a, b) r2 = a.dot(b)
print ("Матрица A:\n", a) print ("Матрица B:\n", b) print ("Результат умножения функцией:\n", r1) print ("Результат умножения методом:\n", r2)
Матрица A: [[1 0] [0 1]] Матрица B: [[4 1] [2 2]] Результат умножения функцией: [[4 1] [2 2]] Результат умножения методом: [[4 1] [2 2]]
Матрицы в NumPy можно умножать и на векторы:
c = np.array([1, 2]) r3 = b.dot(c)
print ("Матрица:\n", b) print ("Вектор:\n", c) print ("Результат умножения:\n", r3)
Матрица: [[4 1] [2 2]] Вектор: [1 2] Результат умножения: [6 6]
Обратите внимание: операция * производит над матрицами покоординатное умножение, а не матричное!
r = a * b
print ("Матрица A:\n", a) print ("Матрица B:\n", b) print ("Результат покоординатного умножения через операцию умножения:\n", r)
Матрица A: [[1 0] [0 1]] Матрица B: [[4 1] [2 2]] Результат покоординатного умножения через операцию умножения: [[4 0] [0 2]]
Более подробно о матричном умножении в NumPy см. документацию.
7. Объединение массивов
Массивы можно Объединенять. Есть горизонтальное и вертикальное объединение.
a = np.floor(10*np.random.random((2,2))) b = np.floor(10*np.random.random((2,2))) print(a) print(b) print() print(np.vstack((a,b))) print() print(np.hstack((a,b)))
[[4. 0.] [1. 4.]] [[9. 7.] [2. 6.]] [[4. 0.] [1. 4.] [9. 7.] [2. 6.]] [[4. 0. 9. 7.] [1. 4. 2. 6.]]
Массивы можно переформировать при помощи метода, который задает новый многомерный массив. Следуя следующему примеру, мы переформатируем одномерный массив из десяти элементов во двумерный массив, состоящий из пяти строк и двух столбцов:
a = np.array(range(10), float) print(a) print() # Превратим в матрицу a = a.reshape((5, 2)) print(a) print() # Вернем обратно print(a.flatten()) # Другой вариант print(a.reshape((-1))) # Превратим в марицу (9, 1) print(a.reshape((-1, 1))) # Превратим в марицу (1, 9) print(a.reshape((1, -1)))
[0. 1. 2. 3. 4. 5. 6. 7. 8. 9.] [[0. 1.] [2. 3.] [4. 5.] [6. 7.] [8. 9.]] [0. 1. 2. 3. 4. 5. 6. 7. 8. 9.] [0. 1. 2. 3. 4. 5. 6. 7. 8. 9.] [[0.] [1.] [2.] [3.] [4.] [5.] [6.] [7.] [8.] [9.]] [[0. 1. 2. 3. 4. 5. 6. 7. 8. 9.]]
Задания: (Блок 1)
Задание 1:
Решите без использования циклов средставми NumPy (каждый пункт решается в 1-2 строчки)
- Создайте вектор с элементами от 12 до 42
- Создайте вектор из нулей длины 12, но его пятый елемент должен быть равен 1
- Создайте матрицу (3, 3), заполненую от 0 до 8
- Найдите все положительные числа в np.array([1,2,0,0,4,0])
- Умножьте матрицу размерности (5, 3) на (3, 2)
- Создайте матрицу (10, 10) так, чтобы на границе были 0, а внтури 1
- Создайте рандомный вектор и отсортируйте его
- Каков эквивалент функции enumerate для numpy массивов?
- *Создайте рандомный вектор и выполните нормализацию столбцов (из каждого столбца вычесть среднее этого столбца, из каждого столбца вычесть sd этого столбца)
- *Для заданного числа найдите ближайший к нему элемент в векторе
- *Найдите N наибольших значений в векторе
# ваш код здесь
Задание 2:
Напишите полностью векторизованный вариант
Дан трёхмерный массив, содержащий изображение, размера (height, width, numChannels), а также вектор длины numChannels. Сложить каналы изображения с указанными весами, и вернуть результат в виде матрицы размера (height, width). Считать реальное изображение можно при помощи функции scipy.misc.imread (если изображение не в формате png, установите пакет pillow: conda install pillow). Преобразуйте цветное изображение в оттенки серого, использовав коэффициенты np.array([0.299, 0.587, 0.114]).
# ваш код здесь
8. Транспонирование матриц
Напоминание теории. Транспонированной матрицей A T называется матрица, полученная из исходной матрицы A заменой строк на столбцы. Формально: элементы матрицы A T определяются как a T ij = aji , где a T ij — элемент матрицы A T , стоящий на пересечении строки с номером i и столбца с номером j .
В NumPy транспонированная матрица вычисляется с помощью функции numpy.transpose() или с помощью метода array.T, где array — нужный двумерный массив.
a = np.array([[1, 2], [3, 4]]) b = np.transpose(a) c = a.T
print ("Матрица:\n", a) print ("Транспонирование функцией:\n", b) print ("Транспонирование методом:\n", c)
Матрица: [[1 2] [3 4]] Транспонирование функцией: [[1 3] [2 4]] Транспонирование методом: [[1 3] [2 4]]
В следующих разделах активно используется модуль numpy.linalg, реализующий некоторые приложения линейной алгебры. Более подробно о функциях, описанных ниже, и различных других функциях этого модуля можно посмотреть в его документации.
9. Определитель матрицы
Напоминание теории. Для квадратных матриц существует понятие определителя.
Пусть A — квадратная матрица. Определителем (или детерминантом) матрицы A ∈ ℝ n×n назовем число
detA = ∑ α1, α2, …, αn ( − 1) N(α1, α2, …, αn) ⋅aα11⋅⋅⋅aαnn,
где α1, α2, …, αn — перестановка чисел от 1 до n , N(α1, α2, …, αn) — число инверсий в перестановке, суммирование ведется по всем возможным перестановкам длины n .
Не стоит расстраиваться, если это определение понятно не до конца — в дальнейшем в таком виде оно не понадобится.
Например, для матрицы размера 2×2 получается:
det ⎛ ⎜ ⎝ a11 a12 a21 a22 ⎞ ⎟ ⎠ = a11a22 − a12a21
Вычисление определителя матрицы по определению требует порядка n! операций, поэтому разработаны методы, которые позволяют вычислять его быстро и эффективно.
В NumPy определитель матрицы вычисляется с помощью функции numpy.linalg.det(a), где a — исходная матрица.
a = np.array([[1, 2, 1], [1, 1, 4], [2, 3, 6]], dtype=np.float32) det = np.linalg.det(a)
print ("Матрица:\n", a) print ("Определитель:\n", det)
Матрица: [[1. 2. 1.] [1. 1. 4.] [2. 3. 6.]] Определитель: -1.0
Рассмотрим одно интересное свойство определителя. Пусть у нас есть параллелограмм с углами в точках (0, 0), (c, d), (a + c, b + d), (a, b) (углы даны в порядке обхода по часовой стрелке). Тогда площадь этого параллелограмма можно вычислить как модуль определителя матрицы ⎛ ⎜ ⎝ a c b d ⎞ ⎟ ⎠ . Похожим образом можно выразить и объем параллелепипеда через определитель матрицы размера 3×3 .
10. Ранг матрицы
Напоминание теории. Рангом матрицы A называется максимальное число линейно независимых строк (столбцов) этой матрицы.
В NumPy ранг матрицы вычисляется с помощью функции numpy.linalg.matrix_rank(M, tol=None), где M — матрица, tol — параметр, отвечающий за некоторую точность вычисления. В простом случае можно его не задавать, и функция сама определит подходящее значение этого параметра.
a = np.array([[1, 2, 3], [1, 1, 1], [2, 2, 2]]) r = np.linalg.matrix_rank(a)
print ("Матрица:\n", a) print ("Ранг матрицы:", r)
Матрица: [[1 2 3] [1 1 1] [2 2 2]] Ранг матрицы: 2
С помощью вычисления ранга матрицы можно проверять линейную независимость системы векторов.
Допустим, у нас есть несколько векторов. Составим из них матрицу, где наши векторы будут являться строками. Понятно, что векторы линейно независимы тогда и только тогда, когда ранг полученной матрицы совпадает с числом векторов. Приведем пример:
a = np.array([1, 2, 3]) b = np.array([1, 1, 1]) c = np.array([2, 3, 5]) m = np.array([a, b, c])
print (np.linalg.matrix_rank(m) == m.shape[0])
True
11. Системы линейных уравнений
Напоминание теории. Системой линейных алгебраических уравнений называется система вида Ax = b , где A ∈ ℝ n×m , x ∈ ℝ m×1 , b ∈ ℝ n×1 . В случае квадратной невырожденной матрицы A решение системы единственно.
В NumPy решение такой системы можно найти с помощью функции numpy.linalg.solve(a, b), где первый аргумент — матрица A , второй — столбец b .
a = np.array([[3, 1], [1, 2]]) b = np.array([9, 8]) x = np.linalg.solve(a, b)
print ("Матрица A:\n", a) print ("Вектор b:\n", b) print ("Решение системы:\n", x)
Матрица A: [[3 1] [1 2]] Вектор b: [9 8] Решение системы: [2. 3.]
Убедимся, что вектор x действительно является решением системы:
print (a.dot(x))
Бывают случаи, когда решение системы не существует. Но хотелось бы все равно “решить” такую систему. Логичным кажется искать такой вектор x , который минимизирует выражение ‖ Ax − b ‖ 2 — так мы приблизим выражение Ax к b .
В NumPy такое псевдорешение можно искать с помощью функции numpy.linalg.lstsq(a, b, . ), где первые два аргумента такие же, как и для функции numpy.linalg.solve(). Помимо решения функция возвращает еще три значения, которые нам сейчас не понадобятся.
a = np.array([[0, 1], [1, 1], [2, 1], [3, 1]]) b = np.array([-1, 0.2, 0.9, 2.1]) x, res, r, s = np.linalg.lstsq(a, b, rcond=None)
print ("Матрица A:\n", a) print ("Вектор b:\n", b) print ("Псевдорешение системы:\n", x)
Матрица A: [[0 1] [1 1] [2 1] [3 1]] Вектор b: [-1. 0.2 0.9 2.1] Псевдорешение системы: [ 1. -0.95]
12. Обращение матриц
Напоминание теории. Для квадратных невырожденных матриц определено понятие обратной матрицы.
Пусть A — квадратная невырожденная матрица. Матрица A − 1 называется обратной матрицей к A , если
AA − 1 = A − 1 A = I,
где I — единичная матрица.
В NumPy обратные матрицы вычисляются с помощью функции numpy.linalg.inv(a), где a — исходная матрица.
a = np.array([[1, 2, 1], [1, 1, 4], [2, 3, 6]], dtype=np.float32) b = np.linalg.inv(a)
print ("Матрица A:\n", a) print ("Обратная матрица к A:\n", b) print ("Произведение A на обратную должна быть единичной:\n", a.dot(b))
Матрица A: [[1. 2. 1.] [1. 1. 4.] [2. 3. 6.]] Обратная матрица к A: [[ 6. 9. -7.] [-2. -4. 3.] [-1. -1. 1.]] Произведение A на обратную должна быть единичной: [[1. 0. 0.] [0. 1. 0.] [0. 0. 1.]]
13. Собственные числа и собственные вектора матрицы
Напоминание теории. Для квадратных матриц определены понятия собственного вектора и собственного числа.
Пусть A — квадратная матрица и A ∈ ℝ n×n . Собственным вектором матрицы A называется такой ненулевой вектор x ∈ ℝ n , что для некоторого λ ∈ ℝ выполняется равенство Ax = λx . При этом λ называется собственным числом матрицы A . Собственные числа и собственные векторы матрицы играют важную роль в теории линейной алгебры и ее практических приложениях.
В NumPy собственные числа и собственные векторы матрицы вычисляются с помощью функции numpy.linalg.eig(a), где a — исходная матрица. В качестве результата эта функция выдает одномерный массив w собственных чисел и двумерный массив v, в котором по столбцам записаны собственные вектора, так что вектор v[:, i] соотвествует собственному числу w[i].
a = np.array([[-1, -6], [2, 6]]) w, v = np.linalg.eig(a)
print ("Матрица A:\n", a) print ("Собственные числа:\n", w) print ("Собственные векторы:\n", v)
Матрица A: [[-1 -6] [ 2 6]] Собственные числа: [2. 3.] Собственные векторы: [[-0.89442719 0.83205029] [ 0.4472136 -0.5547002 ]]
Обратите внимание: у вещественной матрицы собственные значения или собственные векторы могут быть комплексными.
14. Расстояния между векторами
Вспомним некоторые нормы, которые можно ввести в пространстве ℝ n , и рассмотрим, с помощью каких библиотек и функций их можно вычислять в NumPy.
p-норма
p-норма (норма Гёльдера) для вектора x = (x1, …, xn) ∈ ℝ n вычисляется по формуле:
‖ x ‖ p = ( n ∑ i = 1 | xi | p ) 1 ⁄ p , p ≥ 1.
В частных случаях при: * p = 1 получаем ℓ1 норму * p = 2 получаем ℓ2 норму
Далее нам понабится модуль numpy.linalg, реализующий некоторые приложения линейной алгебры. Для вычисления различных норм мы используем функцию numpy.linalg.norm(x, ord=None, . ), где x — исходный вектор, ord — параметр, определяющий норму (мы рассмотрим два варианта его значений — 1 и 2). Импортируем эту функцию:
from numpy.linalg import norm
ℓ1 норма
ℓ1 норма (также известная как манхэттенское расстояние) для вектора x = (x1, …, xn) ∈ ℝ n вычисляется по формуле:
‖ x ‖ 1 = n ∑ i = 1 | xi | .
Ей в функции numpy.linalg.norm(x, ord=None, . ) соответствует параметр ord=1.
a = np.array([1, 2, -3]) print('Вектор a:', a)
Вектор a: [ 1 2 -3]
print('L1 норма вектора a:\n', norm(a, ord=1))
L1 норма вектора a: 6.0
ℓ2 норма
ℓ2 норма (также известная как евклидова норма) для вектора x = (x1, …, xn) ∈ ℝ n вычисляется по формуле:
‖ x ‖ 2 = √ ( n ∑ i = 1 ( xi ) 2 ) .
Ей в функции numpy.linalg.norm(x, ord=None, . ) соответствует параметр ord=2.
print ('L2 норма вектора a:\n', norm(a, ord=2))
L2 норма вектора a: 3.7416573867739413
Более подробно о том, какие еще нормы (в том числе матричные) можно вычислить, см. документацию.
15. Расстояния между векторами
Для двух векторов x = (x1, …, xn) ∈ ℝ n и y = (y1, …, yn) ∈ ℝ n ℓ1 и ℓ2 раccтояния вычисляются по следующим формулам соответственно:
ρ1 ( x, y ) = ‖ x − y ‖ 1 = n ∑ i = 1 | xi − yi |
ρ2 ( x, y ) = ‖ x − y ‖ 2 = √ ( n ∑ i = 1 ( xi − yi ) 2 ) .
a = np.array([1, 2, -3]) b = np.array([-4, 3, 8]) print ('Вектор a:', a) print ('Вектор b:', b)
Вектор a: [ 1 2 -3] Вектор b: [-4 3 8]
print ('L1 расстояние между векторами a и b:\n', norm(a - b, ord=1)) print ('L2 расстояние между векторами a и b:\n', norm(a - b, ord=2))
L1 расстояние между векторами a и b: 17.0 L2 расстояние между векторами a и b: 12.12435565298214
16. Скалярное произведение и угол между векторами
a = np.array([0, 5, -1]) b = np.array([-4, 9, 3]) print ('Вектор a:', a) print ('Вектор b:', b)
Вектор a: [ 0 5 -1] Вектор b: [-4 9 3]
Скалярное произведение в пространстве ℝ n для двух векторов x = (x1, …, xn) и y = (y1, …, yn) определяется как:
⟨x, y⟩ = n ∑ i = 1 xiyi.
Длиной вектора x = (x1, …, xn) ∈ ℝ n называется квадратный корень из скалярного произведения, то есть длина равна евклидовой норме вектора:
| x | = √ ( ⟨x, x⟩ ) = √ ( n ∑ i = 1 x 2 i ) = ‖ x ‖ 2.
Теперь, когда мы знаем расстояние между двумя ненулевыми векторами и их длины, мы можем вычислить угол между ними через скалярное произведение:
⟨x, y⟩ = | x | |y|cos(α) ⟹ cos(α) = ( ⟨x, y⟩ )/( | x | |y| ) ,
где α ∈ [0, π] — угол между векторами x и y .
cos_angle = np.dot(a, b) / norm(a) / norm(b) print ('Косинус угла между a и b:', cos_angle) print ('Сам угол:', np.arccos(cos_angle))
Косинус угла между a и b: 0.8000362836474323 Сам угол: 0.6434406336093618
17. Комплексные числа в питоне
Напоминание теории. Комплексными числами называются числа вида x + iy , где x и y — вещественные числа, а i — мнимая единица (величина, для которой выполняется равенство i 2 = − 1 ). Множество всех комплексных чисел обозначается буквой ℂ (подробнее про комплексные числа см. википедию).
В питоне комплескные числа можно задать следующим образом (j обозначает мнимую единицу):
a = 3 + 2j b = 1j
print ("Комплексное число a:\n", a) print ("Комплексное число b:\n", b)
Комплексное число a: (3+2j) Комплексное число b: 1j
С комплексными числами в питоне можно производить базовые арифметические операции так же, как и с вещественными числами:
c = a * a d = a / (4 - 5j)
print ("Комплексное число c:\n", c) print ("Комплексное число d:\n", d)
Комплексное число c: (5+12j) Комплексное число d: (0.0487804878048781+0.5609756097560976j)
Задания: (Блок 2)
Задание 3:
Рассмотрим сложную математическую функцию на отрезке [1, 15]:
f(x) = sin(x / 5) * exp(x / 10) + 5 * exp(-x / 2)
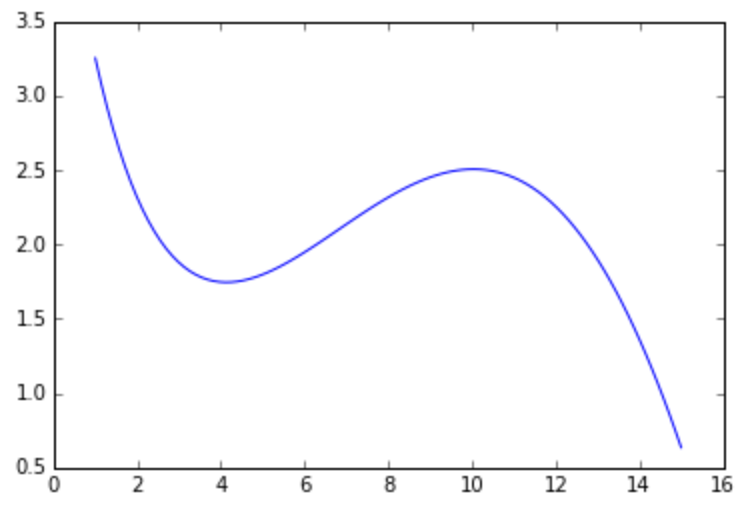
Она может описывать, например, зависимость оценок, которые выставляют определенному сорту вина эксперты, в зависимости от возраста этого вина. Мы хотим приблизить сложную зависимость с помощью функции из определенного семейства. В этом задании мы будем приближать указанную функцию с помощью многочленов.
Как известно, многочлен степени n (то есть w0 + w1x + w2x 2 + … + wnx n ) однозначно определяется любыми n + 1 различными точками, через которые он проходит. Это значит, что его коэффициенты w0 , … wn можно определить из следующей системы линейных уравнений:
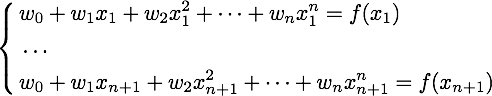
где через x1, . xn, xn + 1 обозначены точки, через которые проходит многочлен, а через f(x1), . f(xn), f(xn + 1) — значения, которые он должен принимать в этих точках.
Воспользуемся описанным свойством, и будем находить приближение функции многочленом, решая систему линейных уравнений.
- Сформируйте систему линейных уравнений (то есть задайте матрицу коэффициентов A и свободный вектор b) для многочлена первой степени, который должен совпадать с функцией f в точках 1 и 15. Решите данную систему с помощью функции scipy.linalg.solve. Нарисуйте функцию f и полученный многочлен. Хорошо ли он приближает исходную функцию?
- Повторите те же шаги для многочлена второй степени, который совпадает с функцией f в точках 1, 8 и 15. Улучшилось ли качество аппроксимации?
- Повторите те же шаги для многочлена третьей степени, который совпадает с функцией f в точках 1, 4, 10 и 15. Хорошо ли он аппроксимирует функцию? Коэффициенты данного многочлена (четыре числа в следующем порядке: w_0, w_1, w_2, w_3) являются ответом на задачу. Округлять коэффициенты не обязательно, но при желании можете произвести округление до второго знака (т.е. до числа вида 0.42)
Сайт построен с использованием Pelican. За основу оформления взята тема от Smashing Magazine. Исходные тексты программ, приведённые на этом сайте, распространяются под лицензией GPLv3, все остальные материалы сайта распространяются под лицензией CC-BY.