Как создать Pandas DataFrame
В этом кратком руководстве мы рассмотрим два метода создания Pandas DataFrame: ввод значений вручную и создание датафрейма на основе значений, импортированных из файла (например, CSV).
Примечание редакции Pythonist: о том, что собой представляет Pandas, можно почитать в статье «Полное руководство по Pandas для начинающих».
Создание Pandas DataFrame путем ввода значений вручную
Чтобы создать Pandas DataFrame в Python, можно следовать этому общему шаблону:
import pandas as pd data = df = pd.DataFrame(data) print(df)
Обратите внимание, что использовать кавычки вокруг числовых значений не нужно (если только вы не хотите получить эти значения в виде строк).
Теперь давайте на простом примере рассмотрим, как применить этот шаблон.
Для начала предположим, что у вас есть следующие данные о товарах, и вы хотите захватить эти данные с помощью датафрейма Pandas:
| product_name | price |
|---|---|
| laptop | 1200 |
| printer | 150 |
| tablet | 300 |
| desk | 450 |
| chair | 200 |
Для создания DataFrame для нашего примера вы можете использовать следующий код:
import pandas as pd data = df = pd.DataFrame(data) print(df)
Запустите этот код в Python, и вы получите такой DataFrame:
product_name price 0 laptop 1200 1 printer 150 2 tablet 300 3 desk 450 4 chair 200
Как видите, каждая строка обозначена числом (также известным как индекс), начиная с 0. В качестве альтернативы вы можете назначить другое значение/имя для обозначения каждой строки.
Например, в приведенном ниже коде мы добавили index=[‘product_1’, ‘product_2’, ‘product_3’, ‘product_4’, ‘product_5’] :
import pandas as pd data = df = pd.DataFrame(data, index=['product_1', 'product_2', 'product_3', 'product_4', 'product_5']) print(df)
Теперь при выводе датафрейма вы увидите новый индекс:
product_name price product_1 laptop 1200 product_2 printer 150 product_3 tablet 300 product_4 desk 450 product_5 chair 200
Импорт значений из CSV-файла для создания Pandas DataFrame
Для импорта данных из CSV-файла в Python для создания DataFrame можно использовать следующий шаблон:
import pandas as pd data = pd.read_csv(r'Path where the CSV file is stored\File name.csv') df = pd.DataFrame(data) print(df)
Допустим, у вас есть следующие данные, хранящиеся в CSV-файле products :
| product_name | price |
|---|---|
| laptop | 1200 |
| printer | 150 |
| tablet | 300 |
| desk | 450 |
| chair | 200 |
В приведенном ниже коде Python вам нужно будет изменить путь, указав местонахождение CSV-файла на вашем компьютере.
Например, пусть путь к нашему CSV-файлу выгдядит так: ‘C:\Users\Ron\Desktop\products.csv’ .
Вот полный код создания датафрейма из данных в нашем файле:
import pandas as pd data = pd.read_csv(r'C:\Users\Ron\Desktop\products.csv') df = pd.DataFrame(data) print(df)
Запустив этот код, вы увидите тот же Pandas DataFrame:
product_name price 0 laptop 1200 1 printer 150 2 tablet 300 3 desk 450 4 chair 200
Такой датафрейм можно создать и путем импорта Excel-файла.
Поиск максимального значения в DataFrame
Поместив данные в Pandas DataFrame, вы можете осуществлять различные манипуляции с ними. Например, подсчитывать статистику.
Допустим, вы хотите найти максимальную цену среди цен всех продуктов в датафрейме.
Конечно, сейчас вы можете это сделать, просто бегло просмотрев цифры на экране, но на практике вы будете работать с большими наборами данных.
Чтобы найти максимальную цену, нужно добавить в наш код следующую строку (и не забыть вывести результат):
max_price = df['price'].max()
import pandas as pd data = df = pd.DataFrame(data) max_price = df['price'].max() print(max_price)
Запустив этот код, вы получите значение 1200, которое и является максимальной ценой в нашем датафрейме.
Узнать больше о создании DataFrame можно в документации Pandas.
Pandas Базовый №2. Создание DataFrame 2
В этом уроке мы научимся создавать DataFrame еще несколькими способами:
- Создать DataFrame из одномерного массива numpy
- Создать DataFrame из двумерного массива numpy
- Создать DataFrame из Series
- Создать DataFrame из Series и словаря
Решение
Сначала нужно импортировать нужные модули.
import numpy as np import pandas as pdСоздать DataFrame из массива numpy
Создаем датафрейм с помощью pandas.DataFrame. В качестве первого параметра передаем np.arange, второй параметр — имена столбцов.
# Создаем DataFrame из одномерного массива numpy pd.DataFrame(np.arange(1, 5), columns=['num'])Создать DataFrame из двумерного массива numpy
В функцию np.array нужно передать список списков. В каждом списке первый элемент будет являться значением для первого столбца, а второй элемент будет являться значением второго столбца.
# Создаем DataFrame из двумерного массива numpy jp_albums = pd.DataFrame(np.array([[1980, 'British Steel'], [1981, 'Point of Entry'], [1982, 'Screaming for Vengeance'], [1984, 'Defenders of the Faith']]), columns=['year', 'album'])Создать DataFrame из нескольких Series
При создании DataFrame из списка Series нельзя сразу задать имена столбцов.
# Создаем DataFrame из Series albums_1 = pd.Series([1986, 'Turbo']) albums_2 = pd.Series([1988, 'Ram it Down']) jp_albums_2 = pd.DataFrame([albums_1, albums_2]) jp_albums_2.columns = ['year', 'album']Создавать DataFrame из словаря серий
Каждая Series — это значения одного столбца.
# Создать DataFrame из Series и словаря albums_3_name = pd.Series(['Painkiller', 'Jugulator']) albums_3_year = pd.Series([1990, 1997]) jp_albums_3 = pd.DataFrame()Что если в одном из столбцов значения есть не для каждой строки
В данном примере для столбца nsongs значения есть не для всех строк. В таком случае в параметре index нужно указать индексы строк, которые нужно заполнить.
# Как произойдет заполнение albums_4_name = pd.Series(['Demolition', 'Angel of Retribution']) albums_4_year = pd.Series([2001, 2005]) albums_4_nsongs = pd.Series([13], index=[0]) jp_albums_4 = pd.DataFrame()Примененные функции
- numpy.arange
- pandas.DataFrame
- numpy.array
- pandas.Series
Курс Pandas Базовый
| Номер урока | Урок | Описание |
|---|---|---|
| 1 | Pandas Базовый №1. Создание DataFrame и запись в CSV | Познакомимся с объектом DataFrame. Научимся его создавать двумя разными способами и научимся записывать его в файл. |
| 2 | Pandas Базовый №2. Создание DataFrame 2 | Изучим еще несколько способов создания объекта DataFrame. В этом уроке мы создадим DataFrame из массива numpy, Series, словаря Series. |
| 3 | Pandas Базовый №3. Отбор строк и столбцов, Размерность, Импорт CSV | Получить информацию о размере DataFrame, отбор строк и столбцов, индексация. |
| 4 | Pandas Базовый №4. Операции со столбцами DataFrame | Операции со столбцами в Pandas. Переименование столбцов, добавление новых столбцов, изменить существующий столбец, удаление столбцов. |
| 5 | Pandas Базовый №5. Операции со строками | Объединение по вертикали методами append и concat, Создание строк вручную, Удаление строк методом drop, Фильтрация строк условием или срезом. |
| 6 | Pandas Базовый №6. Индексы | Зачем нужны индексы, Как задать индекс, Как пользоваться индексами. |
| 7 | Pandas Базовый №7. Категории | Что такое категориальные переменные. |
Как анализировать данные на Python с Pandas: первые шаги
Мария Жарова Эксперт по Python и математике для Data Science, ментор одного из проектов на курсе по Data Science.
Pandas — главная Python-библиотека для анализа данных. Она быстрая и мощная: в ней можно работать с таблицами, в которых миллионы строк. Вместе с Марией Жаровой, ментором проекта на курсе по Data Science, рассказываем про команды, которые позволят начать работать с реальными данными.
Среда разработки
Pandas работает как в IDE (средах разработки), так и в облачных блокнотах для программирования. Как установить библиотеку в конкретную IDE, читайте тут. Мы для примера будем работать в облачной среде Google Colab. Она удобна тем, что не нужно ничего устанавливать на компьютер: файлы можно загружать и работать с ними онлайн, к тому же есть совместный режим для работы с коллегами. Про Colab мы писали в этом обзоре. Пройдите тест и узнайте, какой вы аналитик данных и какие перспективы вас ждут. Ссылка в конце статьи.
Data Scientist с нуля до PRO
Освойте профессию Data Scientist с нуля до уровня PRO на углубленном курсе совместно с академиком РАН из МГУ. Изучите продвинутую математику с азов, получите реальный опыт на практических проектах и начните работать удаленно из любой точки мира.
25 месяцев
Data Scientist с нуля до PRO
Создавайте ML-модели и работайте с нейронными сетями
6 790 ₽/мес 11 317 ₽/мес
Анализ данных в Pandas
-
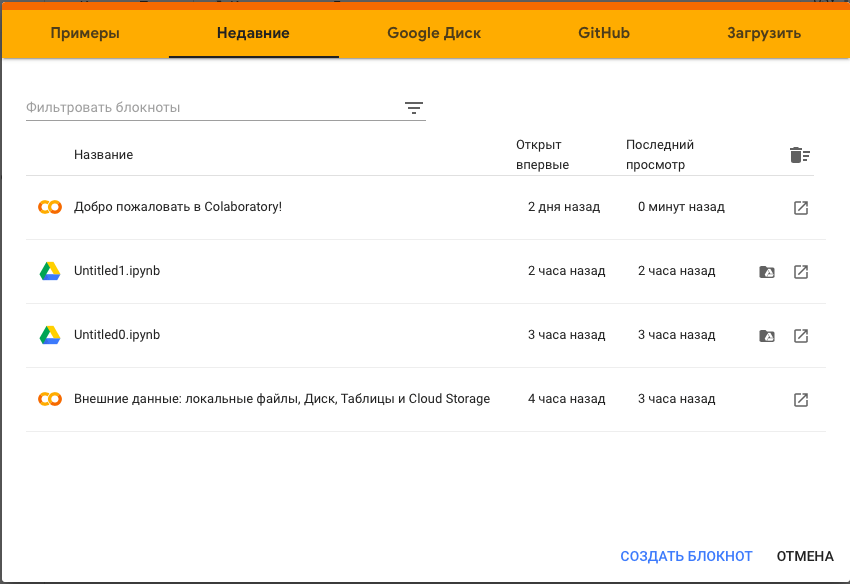
Создание блокнота в Google Colab На сайте Google Colab сразу появляется экран с доступными блокнотами. Создадим новый блокнот:
Импортирование библиотеки Pandas недоступна в Python по умолчанию. Чтобы начать с ней работать, нужно ее импортировать с помощью этого кода:
import pandas as pd
pd — это распространенное сокращенное название библиотеки. Далее будем обращаться к ней именно так.
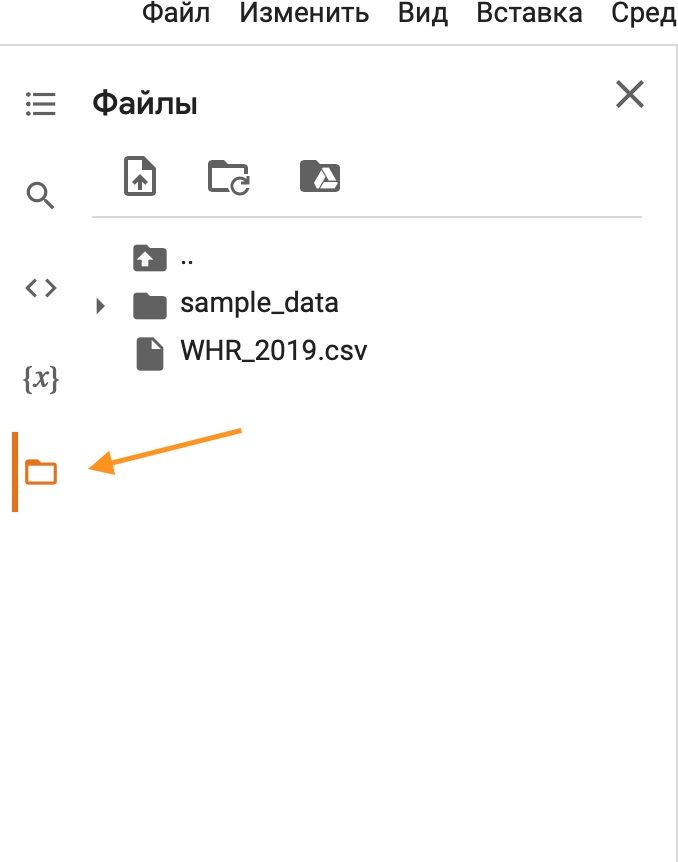
И прочитать с помощью такой команды:
Это можно сделать через словарь и через преобразование вложенных списков (фактически таблиц).
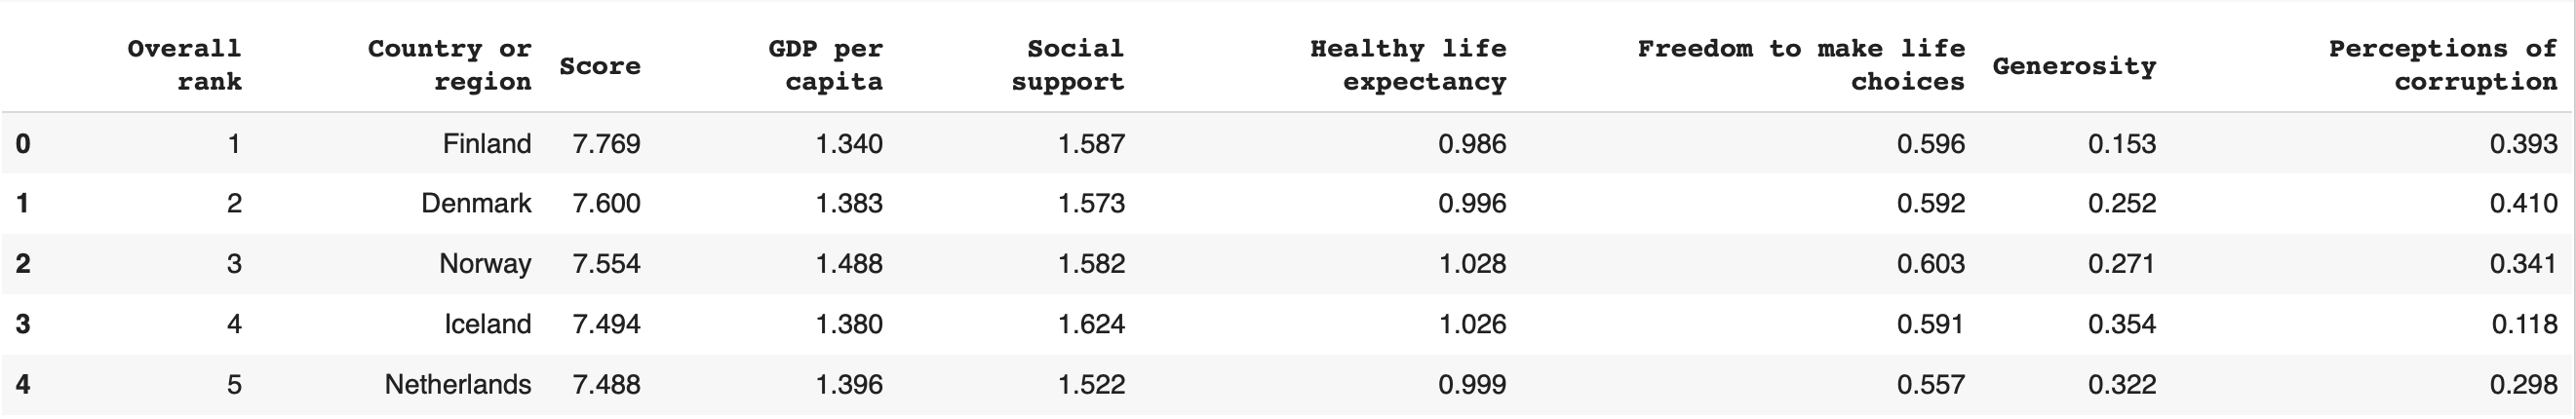
Если нужно посмотреть на другое количество строк, оно указывается в скобках, например df.head(12) . Последние строки фрейма выводятся методом .tail() .
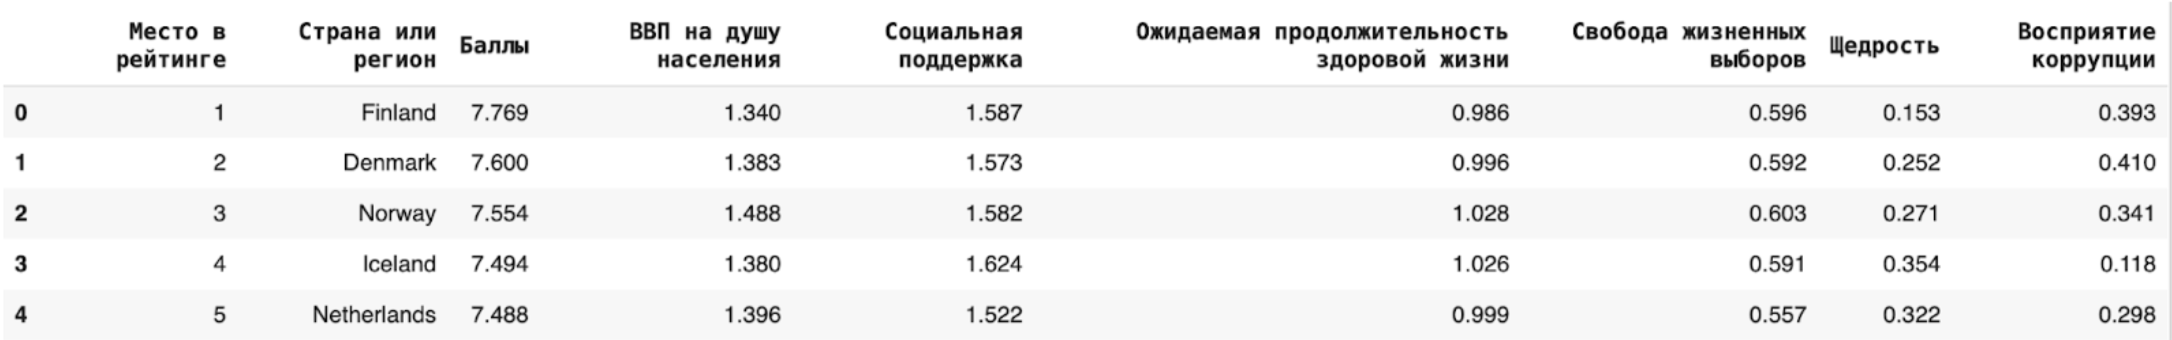
Также чтобы просто полностью красиво отобразить датасет, используется функция display() . По умолчанию в Jupyter Notebook, если написать имя переменной на последней строке какой-либо ячейки (даже без ключевого слова display), ее содержимое будет отображено.
Характеристики датасета Чтобы получить первичное представление о статистических характеристиках нашего датасета, достаточно этой команды: df.describe()
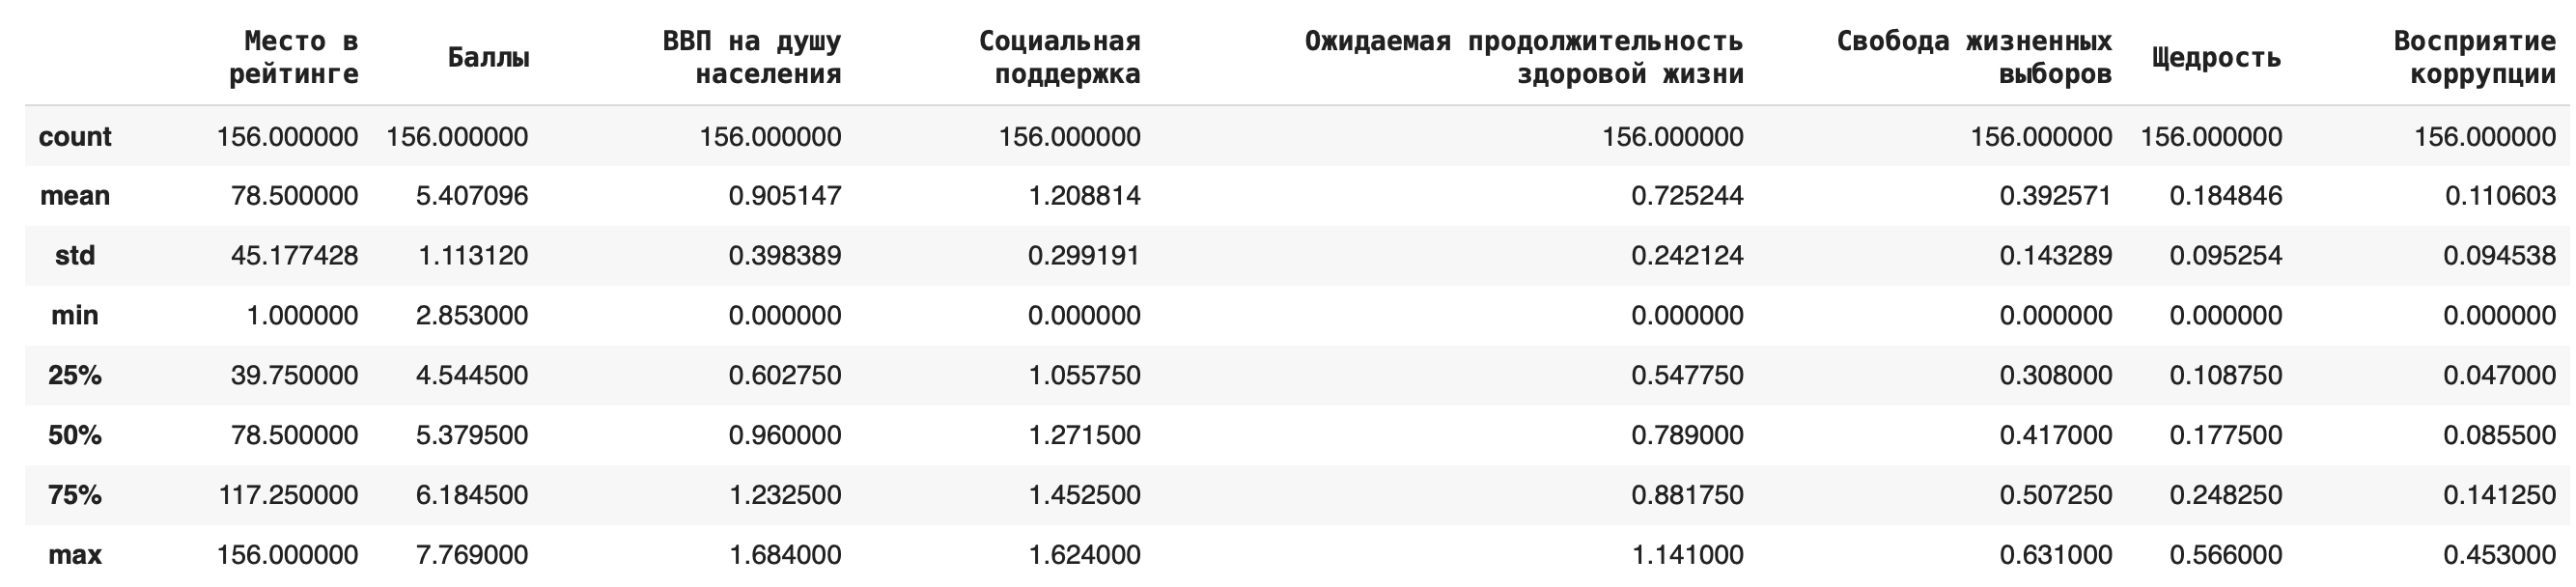
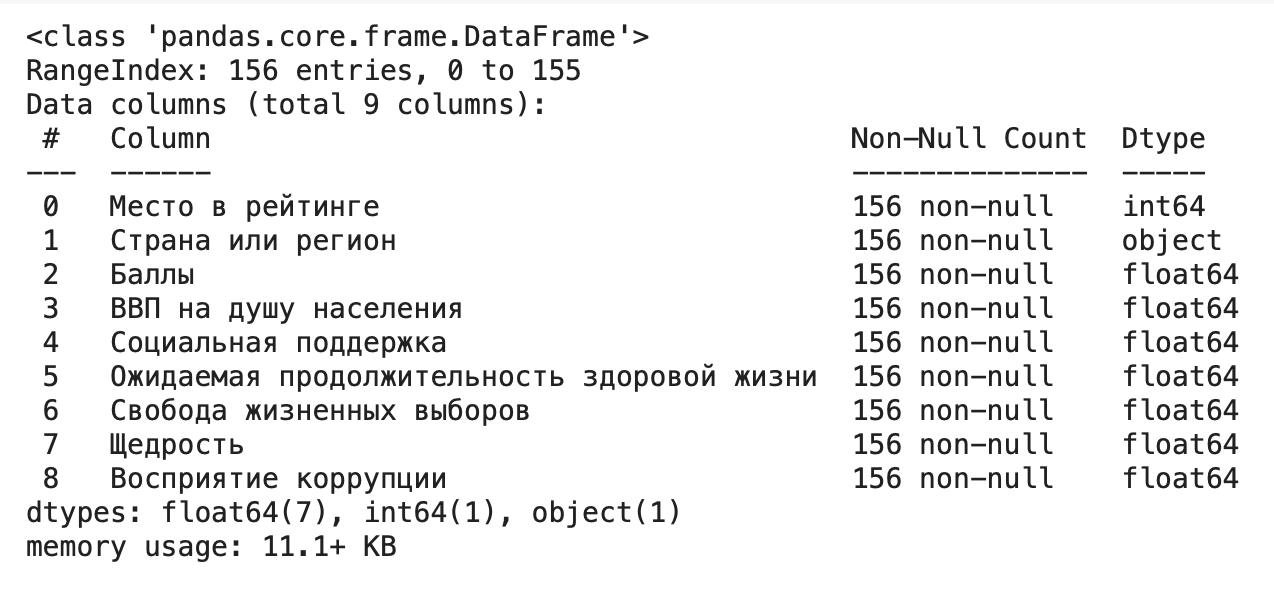
Обзор содержит среднее значение, стандартное отклонение, минимум и максимум, верхние значения первого и третьего квартиля и медиану по каждому столбцу.
Работа с отдельными столбцами или строками
Выделить несколько столбцов можно разными способами.
1. Сделать срез фрейма df[[‘Место в рейтинге’, ‘Ожидаемая продолжительность здоровой жизни’]]
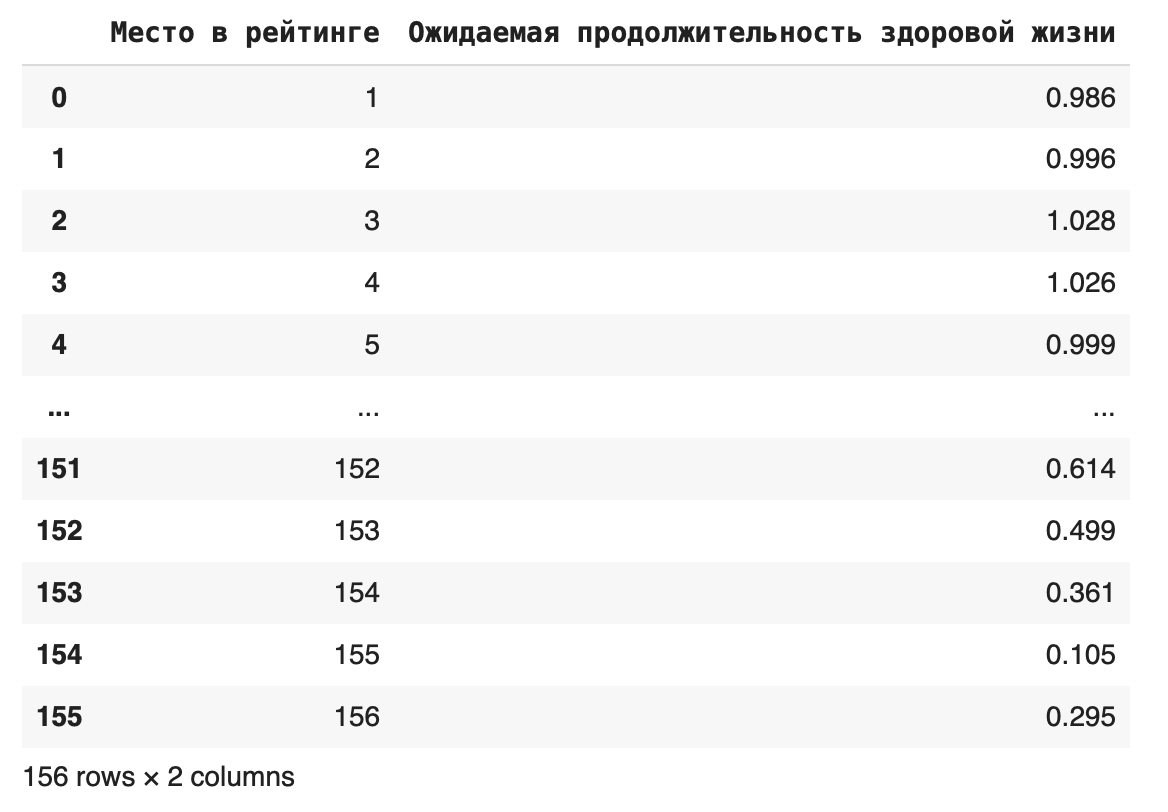
Срез можно сохранить в новой переменной: data_new = df[[‘Место в рейтинге’, ‘Ожидаемая продолжительность здоровой жизни’]]
Теперь можно выполнить любое действие с этим сокращенным фреймом.
2. Использовать метод loc
Если столбцов очень много, можно использовать метод loc, который ищет значения по их названию: df.loc [:, ‘Место в рейтинге’:’Социальная поддержка’]
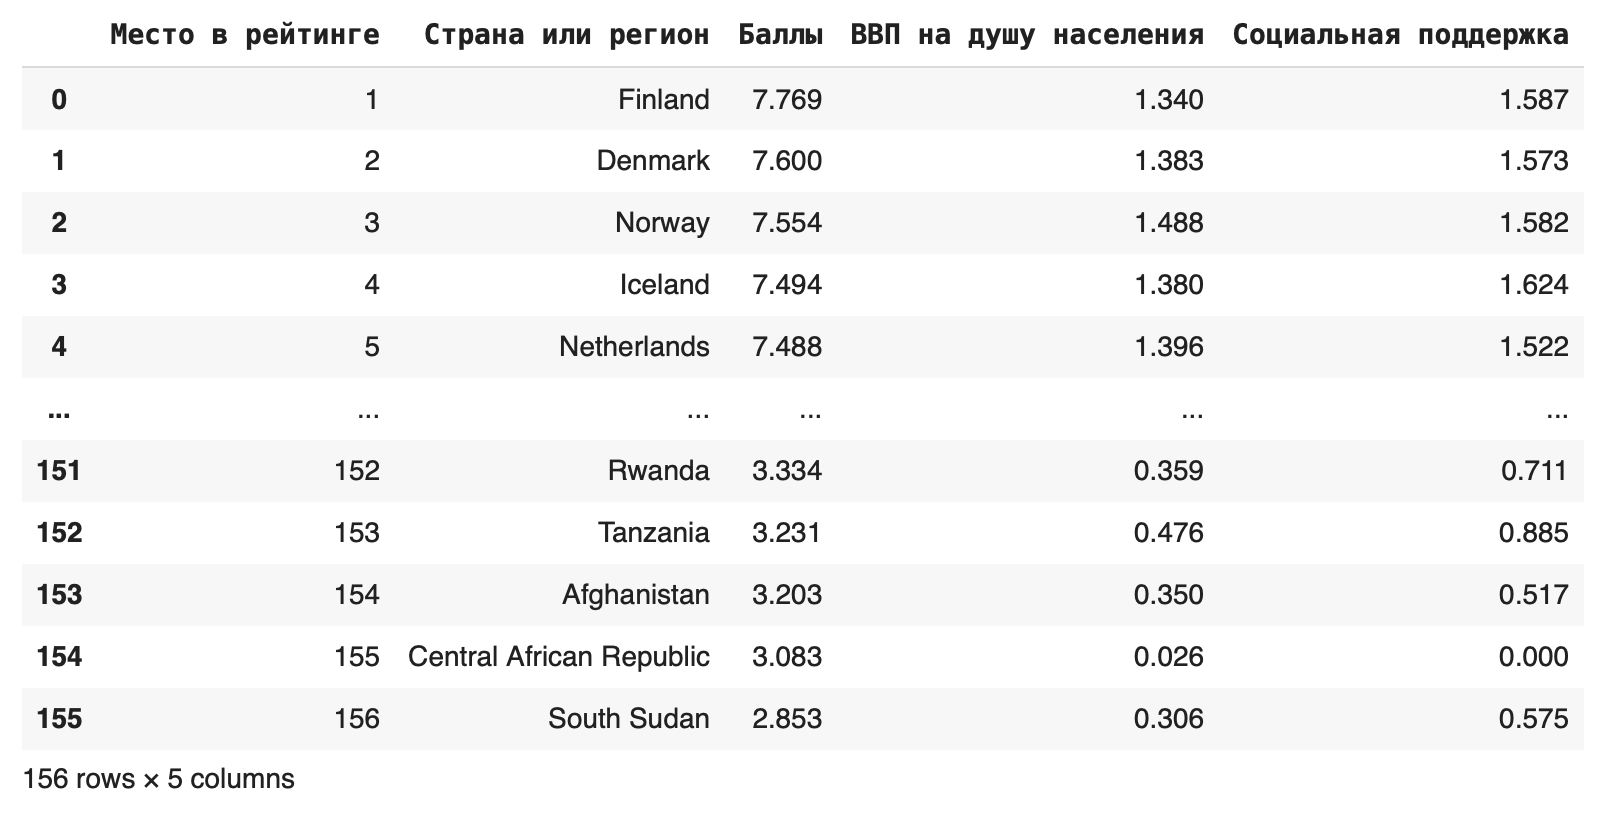
В этом случае мы оставили все столбцы от Места в рейтинге до Социальной поддержки.
Станьте дата-сайентистом на курсе с МГУ и решайте амбициозные задачи с помощью нейросетей
3. Использовать метод iloc
Если нужно вырезать одновременно строки и столбцы, можно сделать это с помощью метода iloc: df.iloc[0:100, 0:5]
Первый параметр показывает индексы строк, которые останутся, второй — индексы столбцов. Получаем такой фрейм:
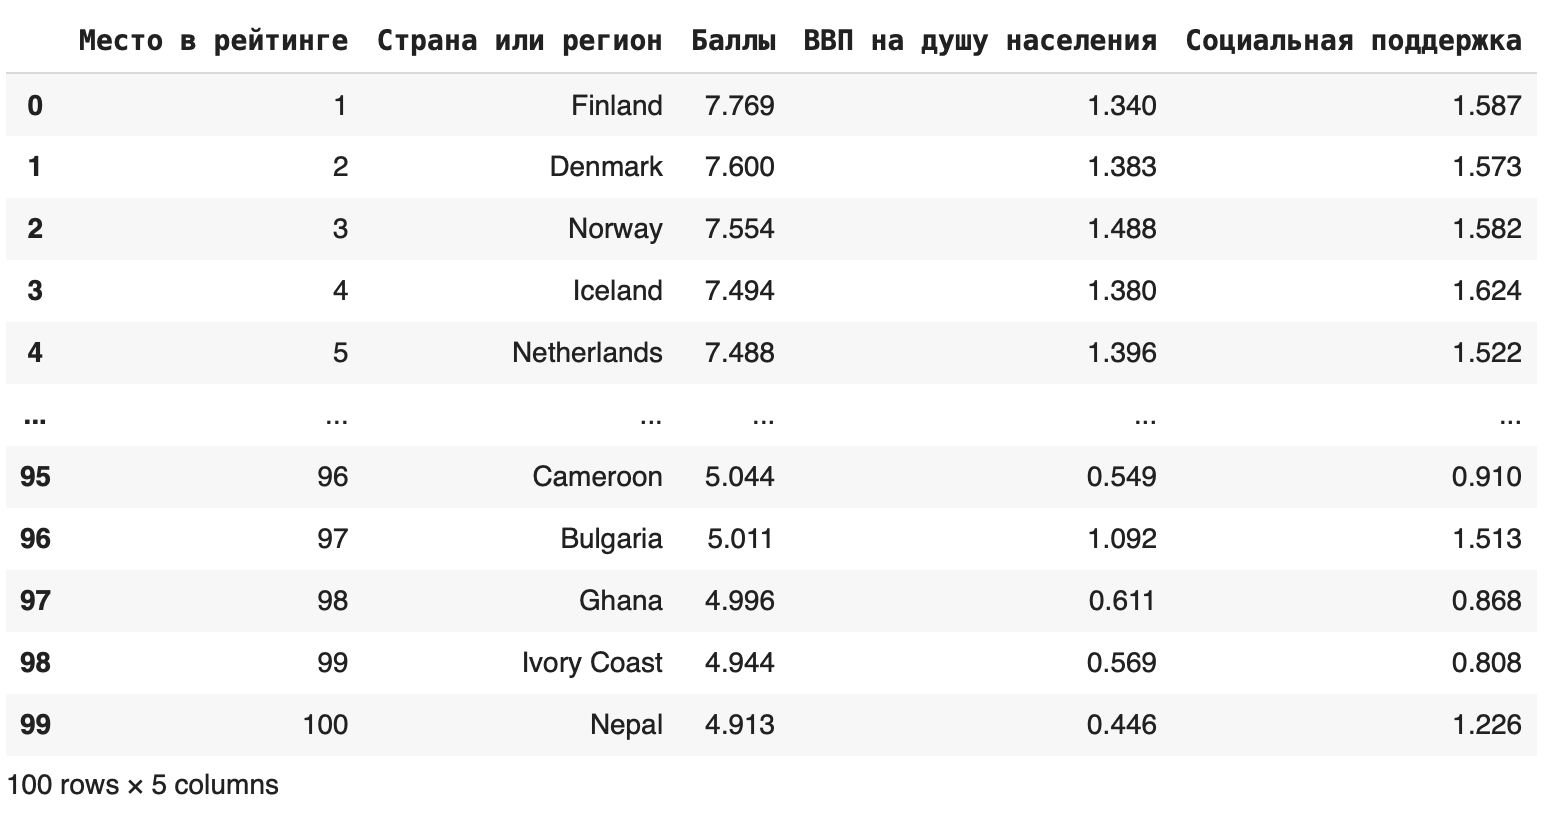
В методе iloc значения в правом конце исключаются, поэтому последняя строка, которую мы видим, — 99.
4. Использовать метод tolist()
Можно выделить какой-либо столбец в отдельный список при помощи метода tolist(). Это упростит задачу, если необходимо извлекать данные из столбцов: df[‘Баллы’].tolist()
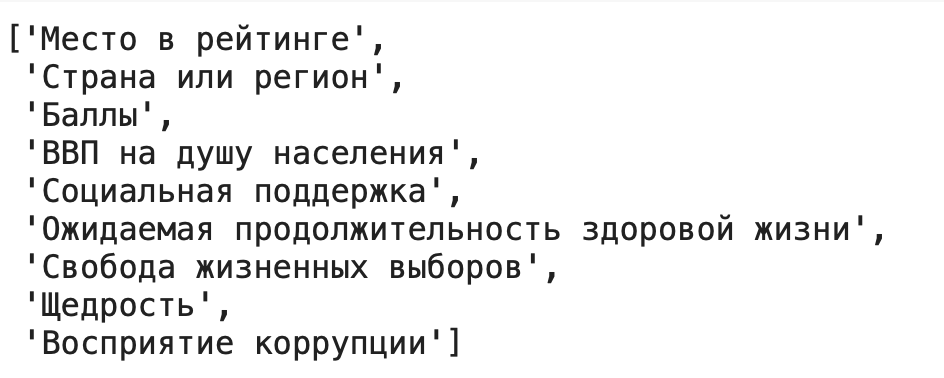
Часто бывает нужно получить в виде списка названия столбцов датафрейма. Это тоже можно сделать с помощью метода tolist(): df.columns.tolist()
Добавление новых строк и столбцов
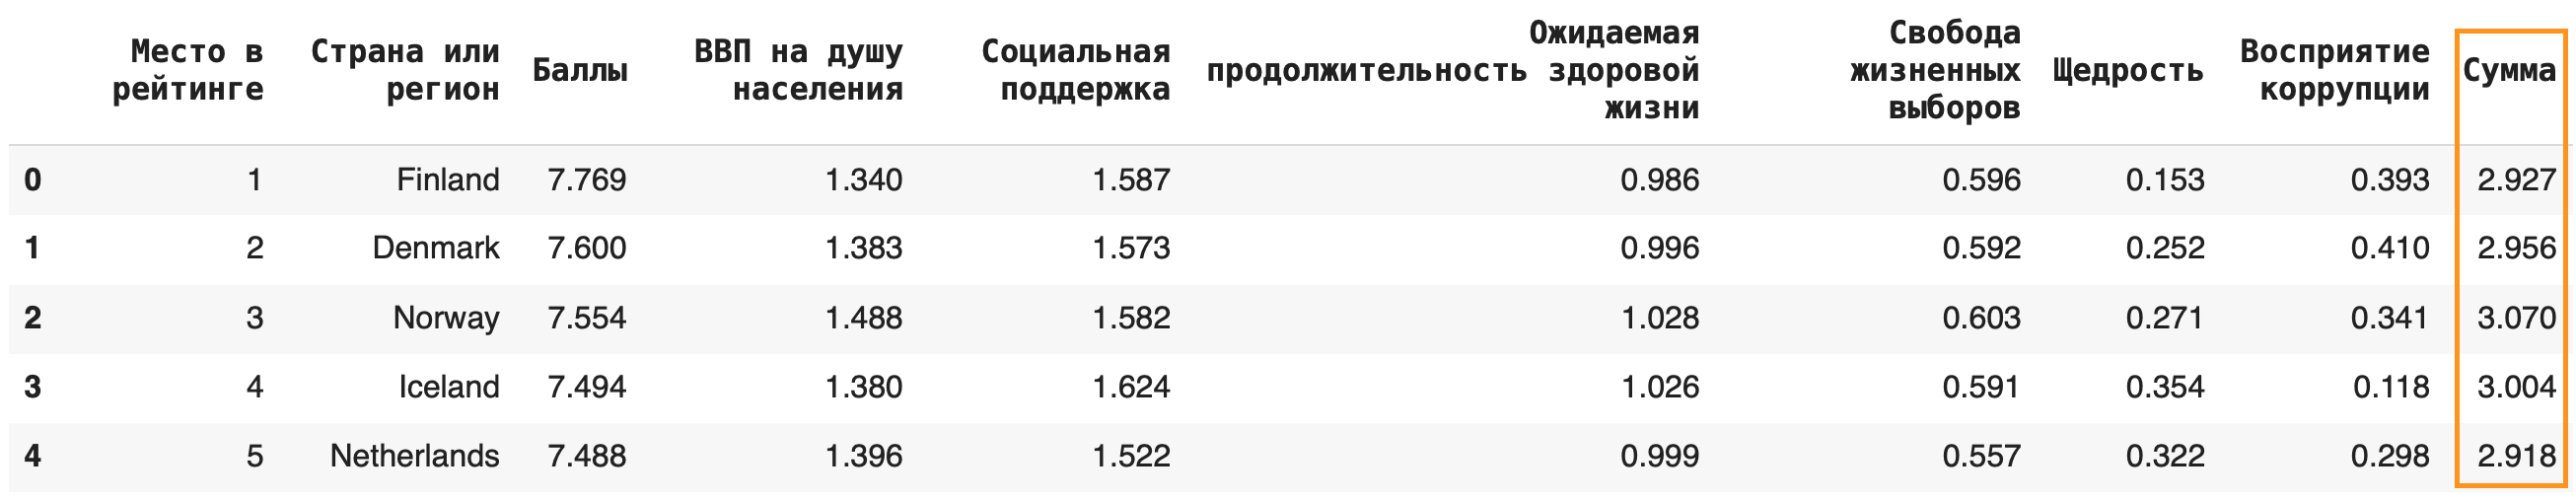
В исходный датасет можно добавлять новые столбцы, создавая новые «признаки», как говорят в машинном обучении. Например, создадим столбец «Сумма», в который просуммируем значения колонок «ВВП на душу населения» и «Социальная поддержка» (сделаем это в учебных целях, практически суммирование этих показателей не имеет смысла): df[‘Сумма’] = df[‘ВВП на душу населения’] + df[‘Социальная поддержка’]
Можно добавлять и новые строки: для этого нужно составить словарь с ключами — названиями столбцов. Если вы не укажете значения в каких-то столбцах, они по умолчанию заполнятся пустыми значениями NaN. Добавим еще одну страну под названием Country: new_row = df = df.append(new_row, ignore_index=True)
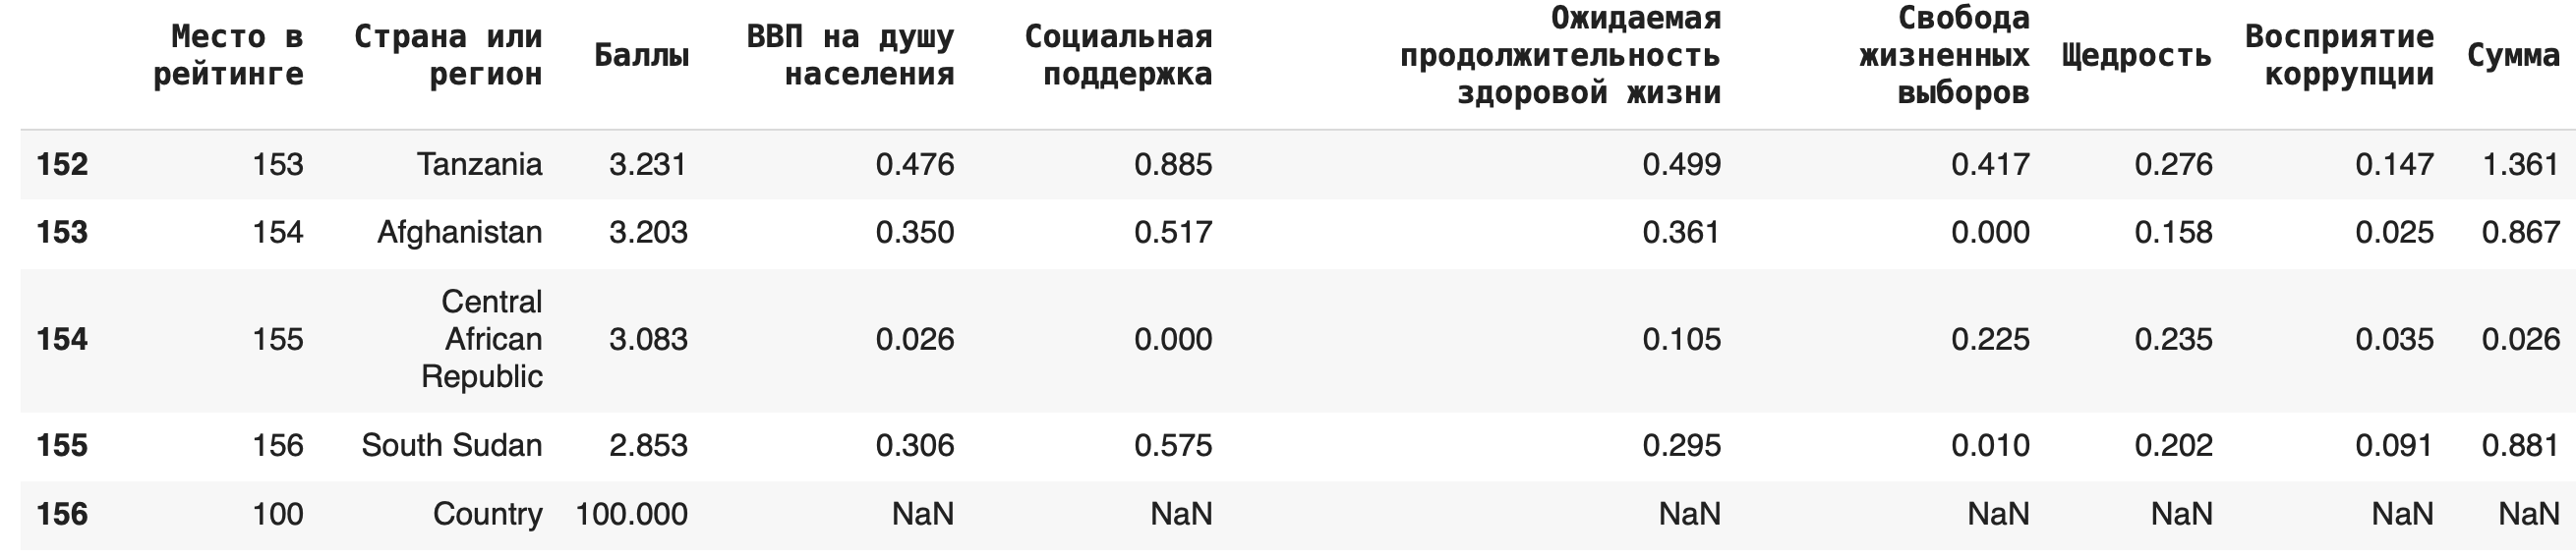
Важно: при добавлении новой строки методом .append() не забывайте указывать параметр ignore_index=True, иначе возникнет ошибка.
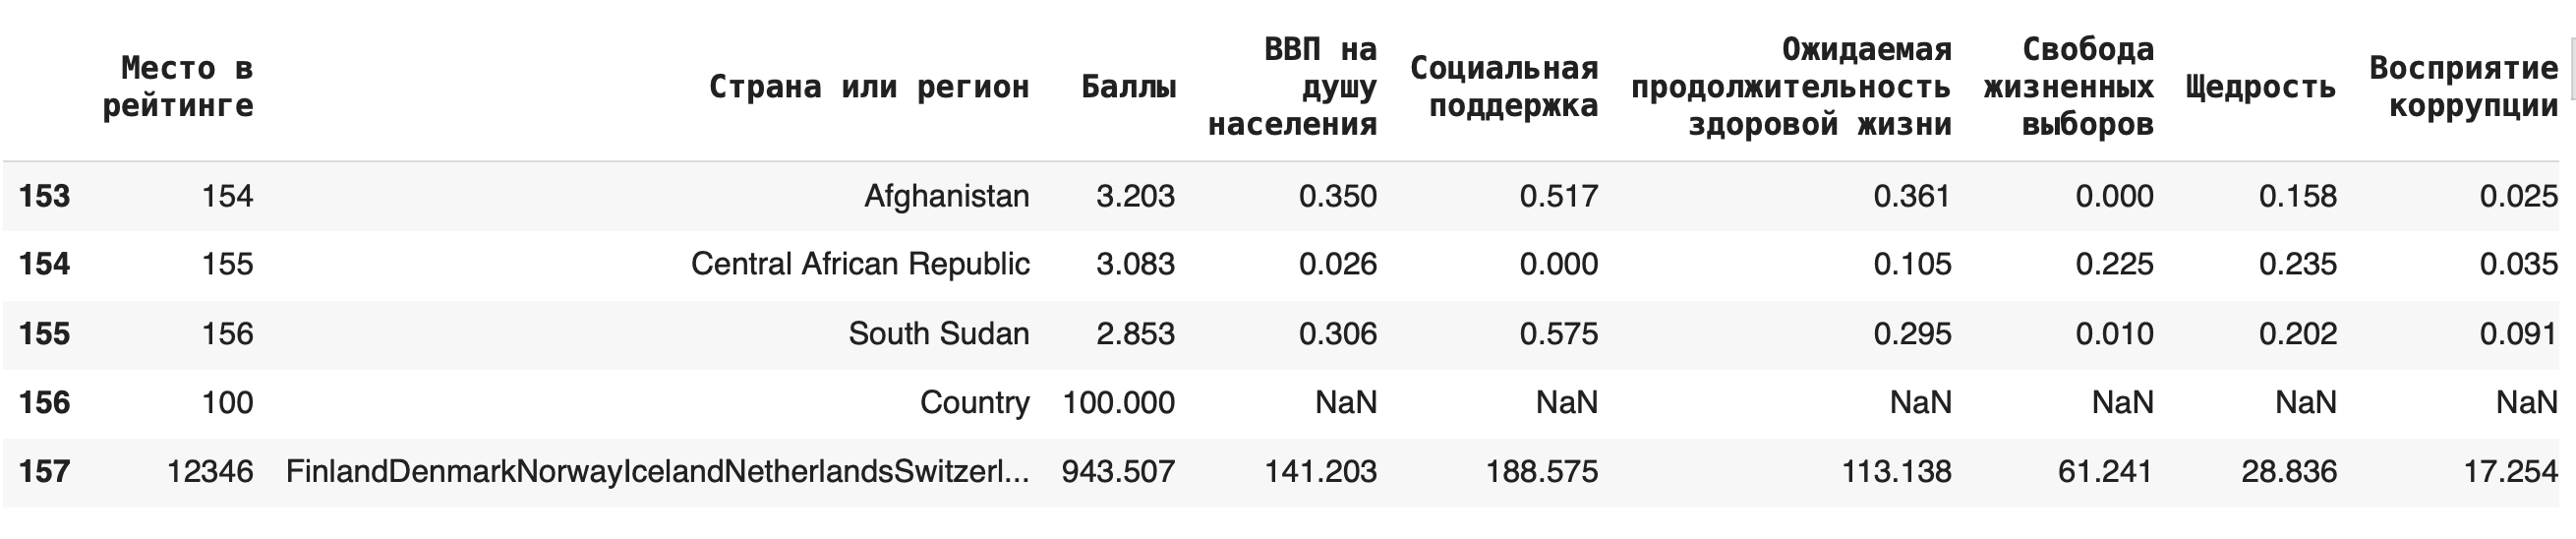
Иногда бывает полезно добавить строку с суммой, медианой или средним арифметическим) по столбцу. Сделать это можно с помощью агрегирующих (aggregate (англ.) — группировать, объединять) функций: sum(), mean(), median(). Для примера добавим в конце строку с суммами значений по каждому столбцу: df = df.append(df.sum(axis=0), ignore_index = True)
Удаление строк и столбцов
Удалить отдельные столбцы можно при помощи метода drop() — это целесообразно делать, если убрать нужно небольшое количество столбцов. df = df.drop([‘Сумма’], axis = 1)
В других случаях лучше воспользоваться описанными выше срезами.
Обратите внимание, что этот метод требует дополнительного сохранения через присваивание датафрейма с примененным методом исходному. Также в параметрах обязательно нужно указать axis = 1, который показывает, что мы удаляем именно столбец, а не строку.
Соответственно, задав параметр axis = 0, можно удалить любую строку из датафрейма: для этого нужно написать ее номер в качестве первого аргумента в методе drop(). Удалим последнюю строчку (указываем ее индекс — это будет количество строк): df = df.drop(df.shape[0]-1, axis = 0)
Копирование датафрейма
Можно полностью скопировать исходный датафрейм в новую переменную. Это пригодится, если нужно преобразовать много данных и при этом работать не с отдельными столбцами, а со всеми данными: df_copied = df.copy()
Уникальные значения
Уникальные значения в какой-либо колонке датафрейма можно вывести при помощи метода .unique(): df[‘Страна или регион’].unique()
Чтобы дополнительно узнать их количество, можно воспользоваться функцией len(): len(df[‘Страна или регион’].unique())
Подсчет количества значений
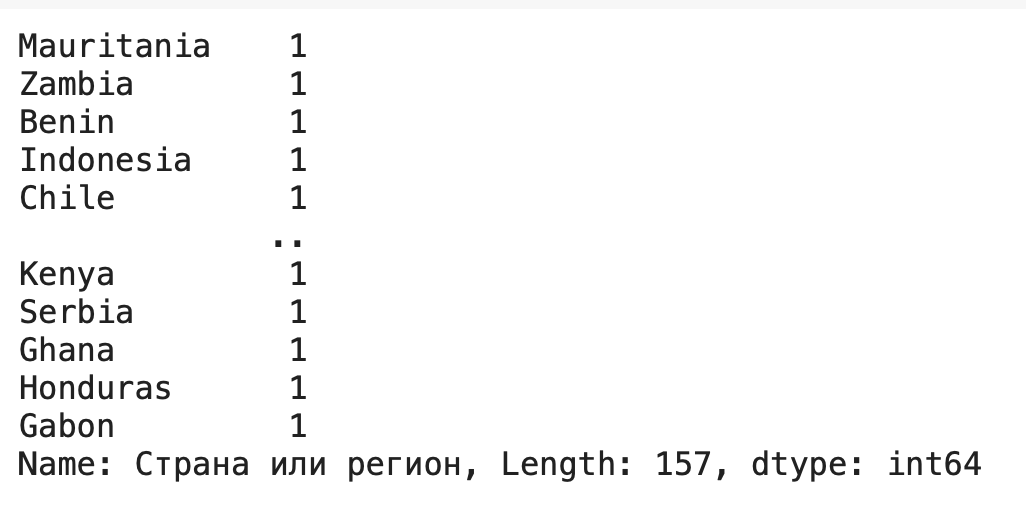
Отличается от предыдущего метода тем, что дополнительно подсчитывает количество раз, которое то или иное уникальное значение встречается в колонке, пишется как .value_counts(): df[‘Страна или регион’].value_counts()
Группировка данных
Некоторым обобщением .value_counts() является метод .groupby() — он тоже группирует данные какого-либо столбца по одинаковым значениям. Отличие в том, что при помощи него можно не просто вывести количество уникальных элементов в одном столбце, но и найти для каждой группы сумму / среднее значение / медиану по любым другим столбцам.
Рассмотрим несколько примеров. Чтобы они были более наглядными, округлим все значения в столбце «Баллы» (тогда в нем появятся значения, по которым мы сможем сгруппировать данные): df[‘Баллы_new’] = round(df[‘Баллы’])
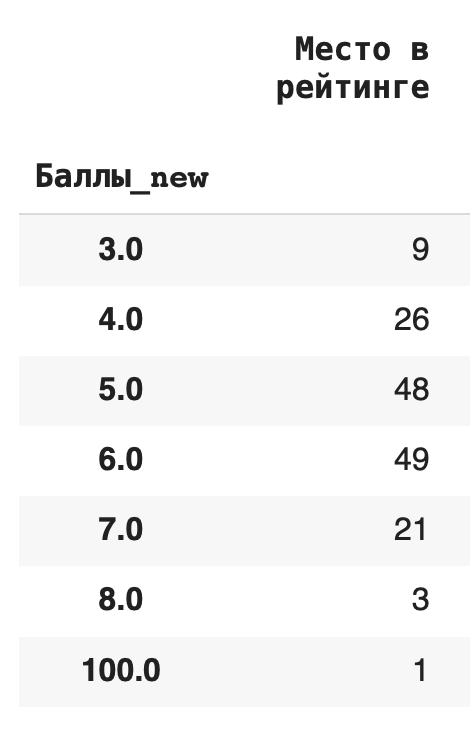
1) Сгруппируем данные по новому столбцу баллов и посчитаем, сколько уникальных значений для каждой группы содержится в остальных столбцах. Для этого в качестве агрегирующей функции используем .count(): df.groupby(‘Баллы_new’).count()
Получается, что чаще всего страны получали 6 баллов (таких было 49):
2) Получим более содержательный для анализа данных результат — посчитаем сумму значений в каждой группе. Для этого вместо .count() используем sum(): df.groupby(‘Баллы_new’).sum()
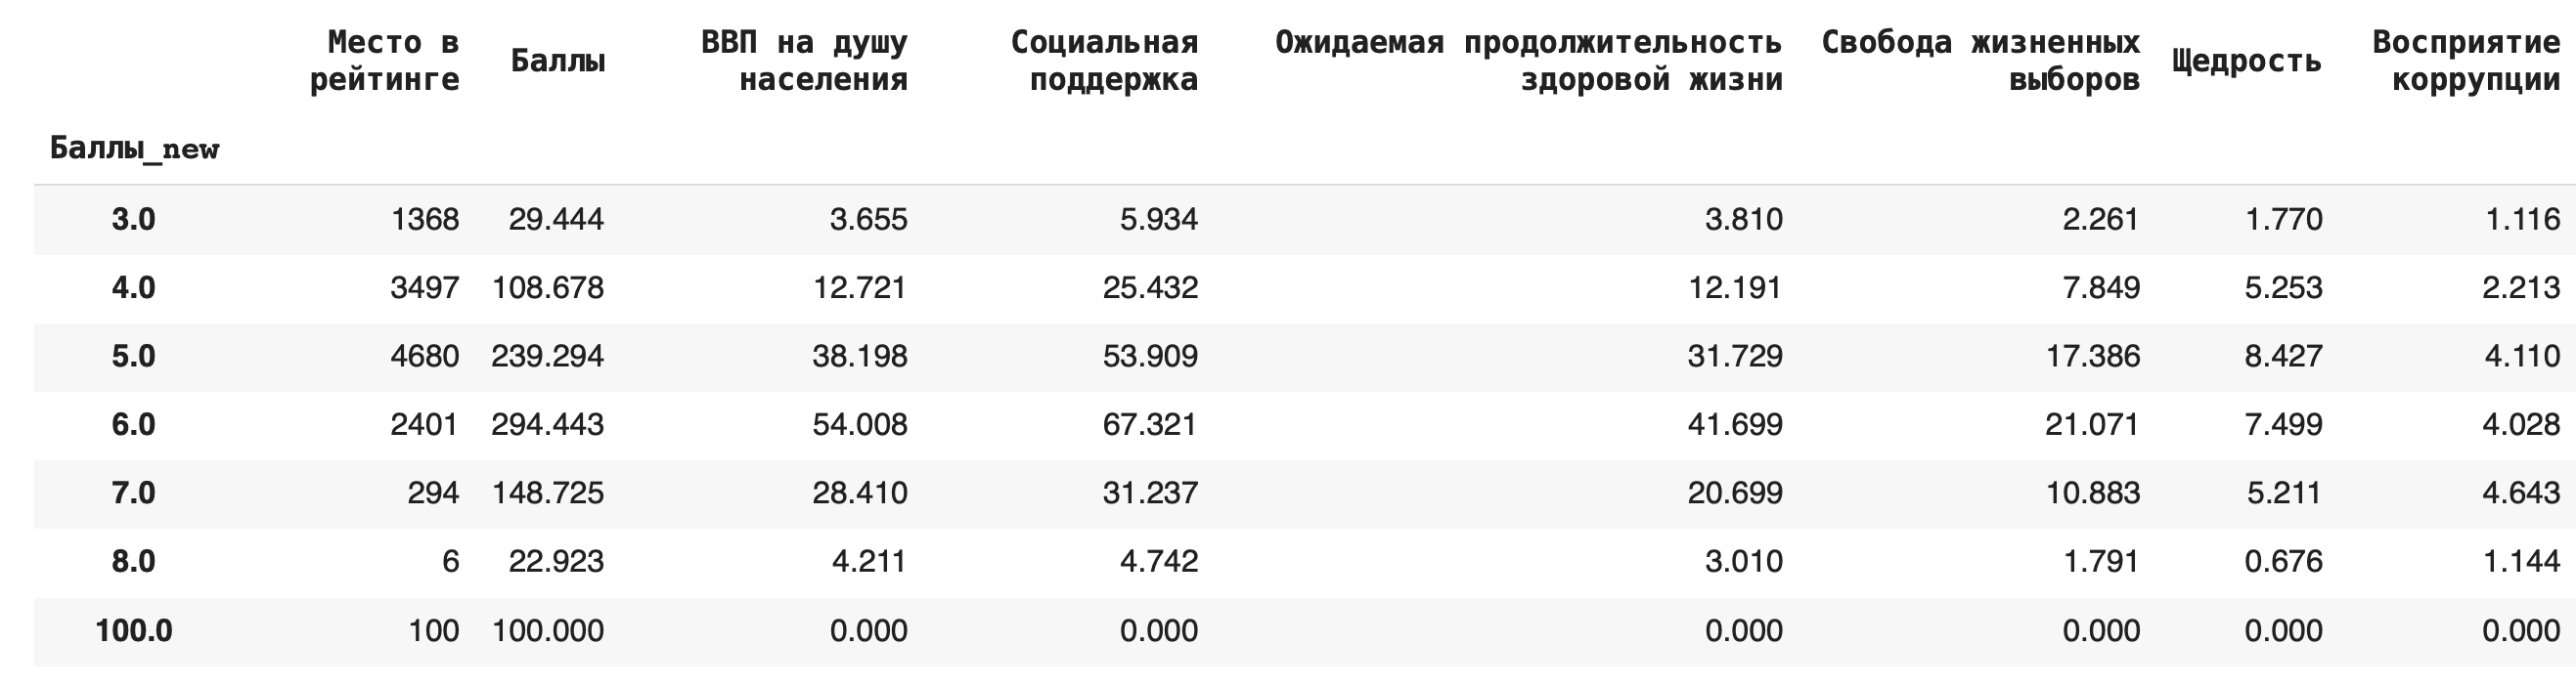
3) Теперь рассчитаем среднее значение по каждой группе, в качестве агрегирующей функции в этом случае возьмем mean(): df.groupby(‘Баллы_new’).mean()
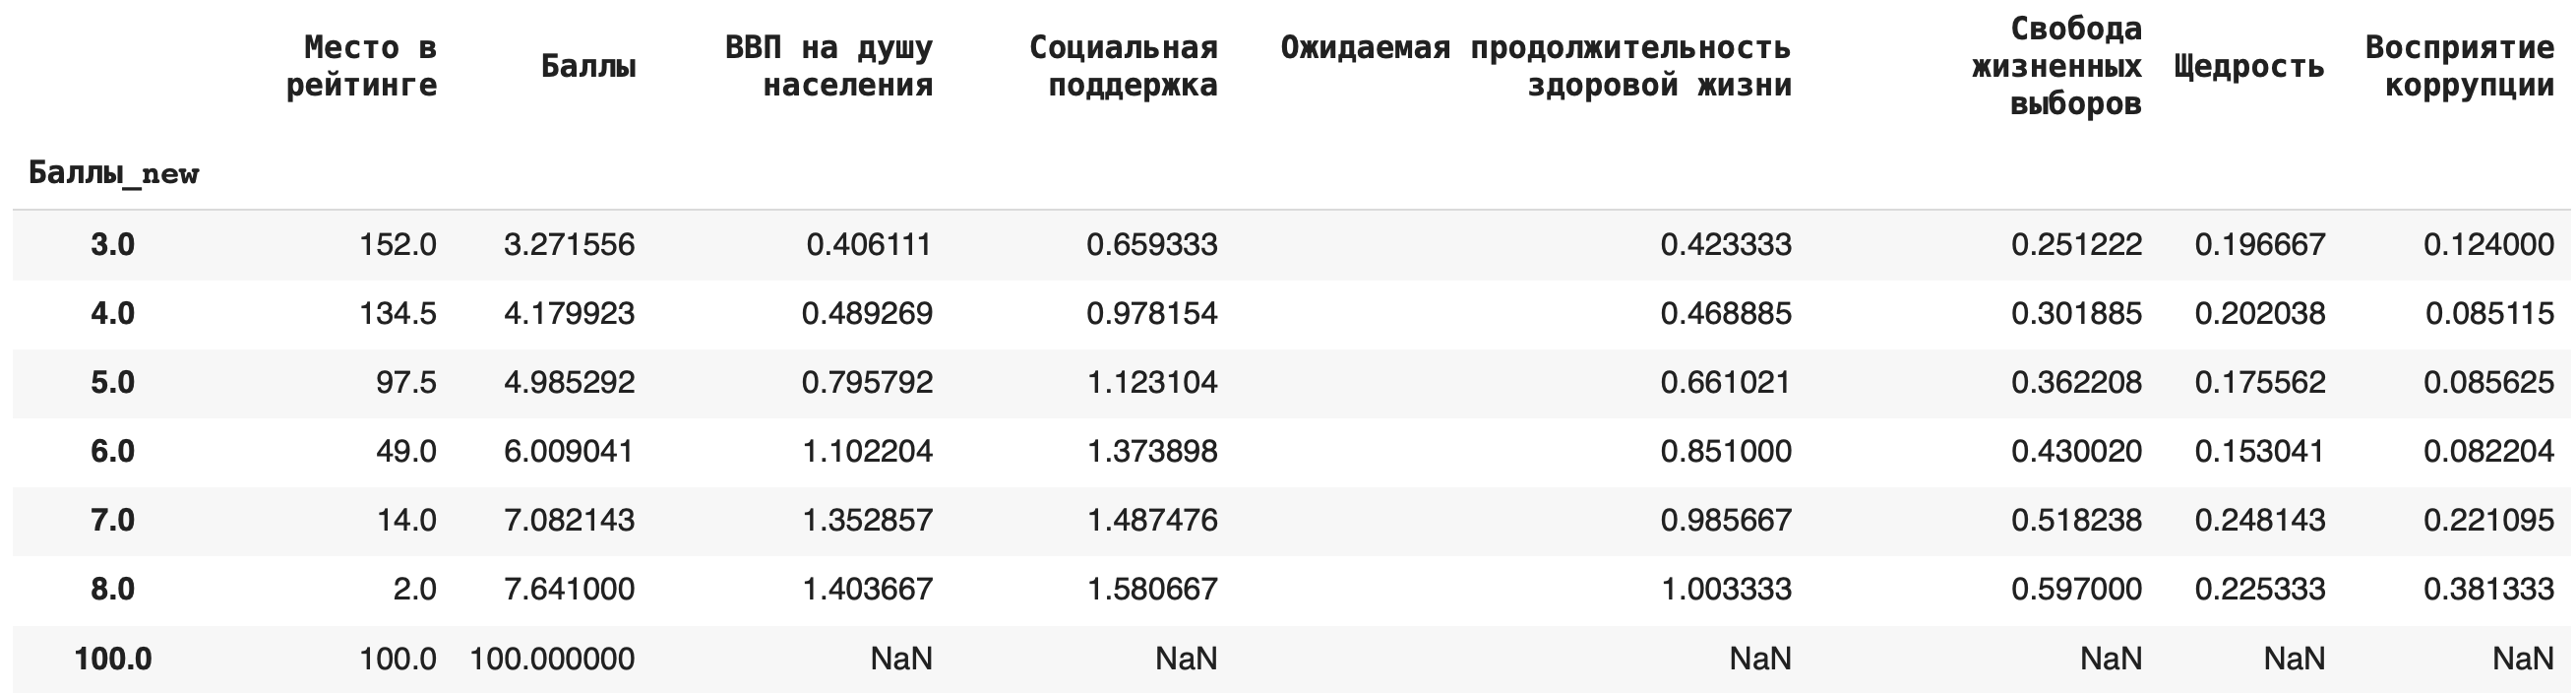
4) Рассчитаем медиану. Для этого пишем команду median(): df.groupby(‘Баллы_new’).median()
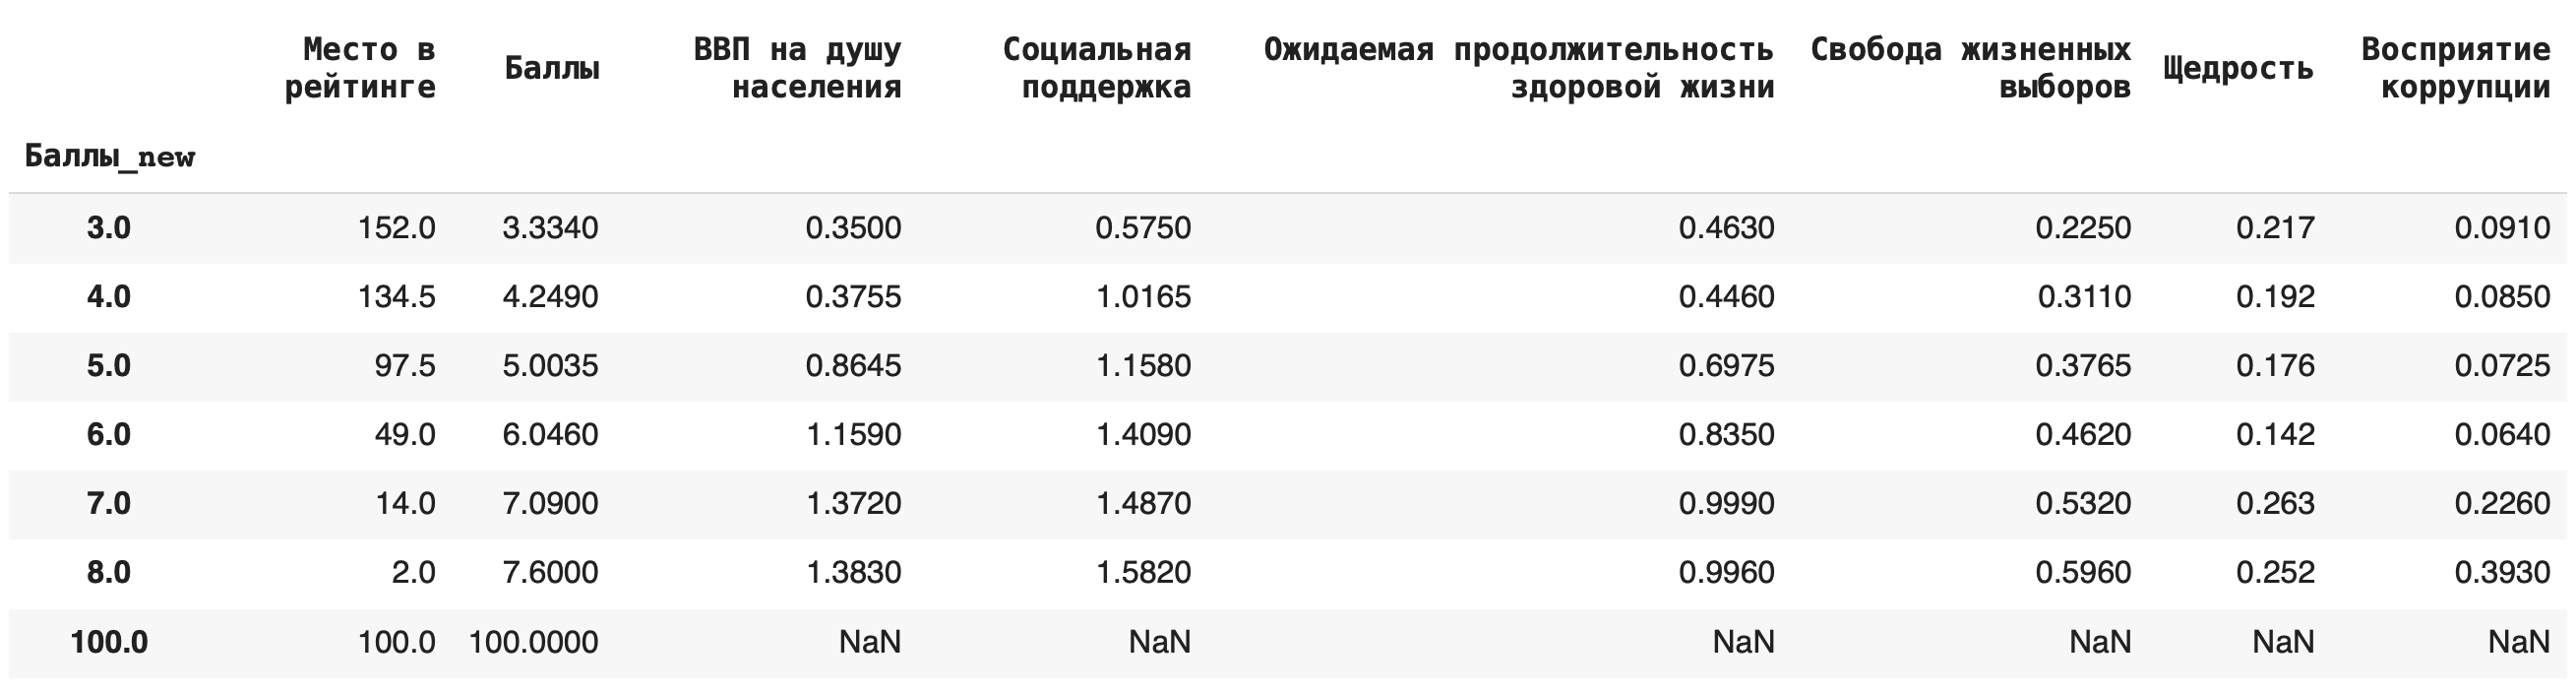
Это самые основные агрегирующие функции, которые пригодятся на начальном этапе работы с данными.
Вот пример синтаксиса, как можно сагрегировать значения по группам при помощи сразу нескольких функций:
df_agg = df.groupby(‘Баллы_new’).agg(< 'Баллы_new': 'count', 'Баллы_new': 'sum', 'Баллы_new': 'mean', 'Баллы_new': 'median' >)
Сводные таблицы
Бывает, что нужно сделать группировку сразу по двум параметрам. Для этого в Pandas используются сводные таблицы или pivot_table(). Они составляются на основе датафреймов, но, в отличие от них, группировать данные можно не только по значениям столбцов, но и по строкам.
В ячейки такой таблицы помещаются сгруппированные как по «координате» столбца, так и по «координате» строки значения. Соответствующую агрегирующую функцию указываем отдельным параметром.
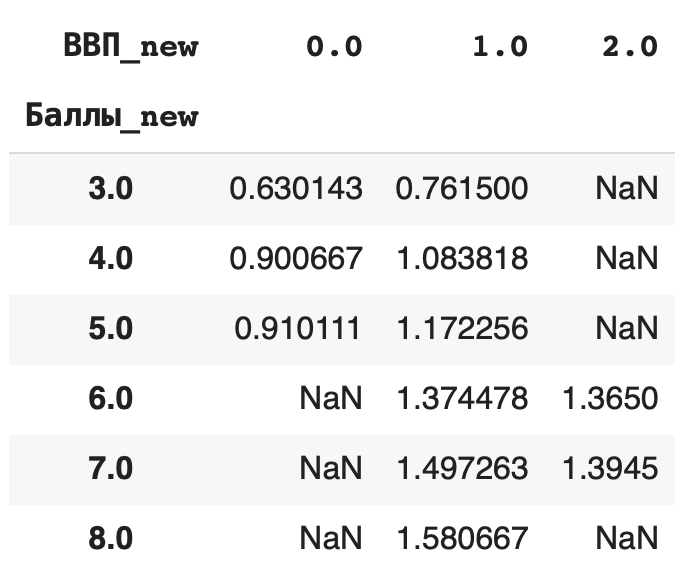
Разберемся на примере. Сгруппируем средние значения из столбца «Социальная поддержка» по баллам в рейтинге и значению ВВП на душу населения. В прошлом действии мы уже округлили значения баллов, теперь округлим и значения ВВП: df[‘ВВП_new’] = round(df[‘ВВП на душу населения’])
Теперь составим сводную таблицу: по горизонтали расположим сгруппированные значения из округленного столбца «ВВП» (ВВП_new), а по вертикали — округленные значения из столбца «Баллы» (Баллы_new). В ячейках таблицы будут средние значения из столбца «Социальная поддержка», сгруппированные сразу по этим двум столбцам: pd.pivot_table(df, index = [‘Баллы_new’], columns = [‘ВВП_new’], values = ‘Социальная поддержка’, aggfunc = ‘mean’)
Сортировка данных
Строки датасета можно сортировать по значениям любого столбца при помощи функции sort_values(). По умолчанию метод делает сортировку по убыванию. Например, отсортируем по столбцу значений ВВП на душу населения: df.sort_values(by = ‘ВВП на душу населения’).head()
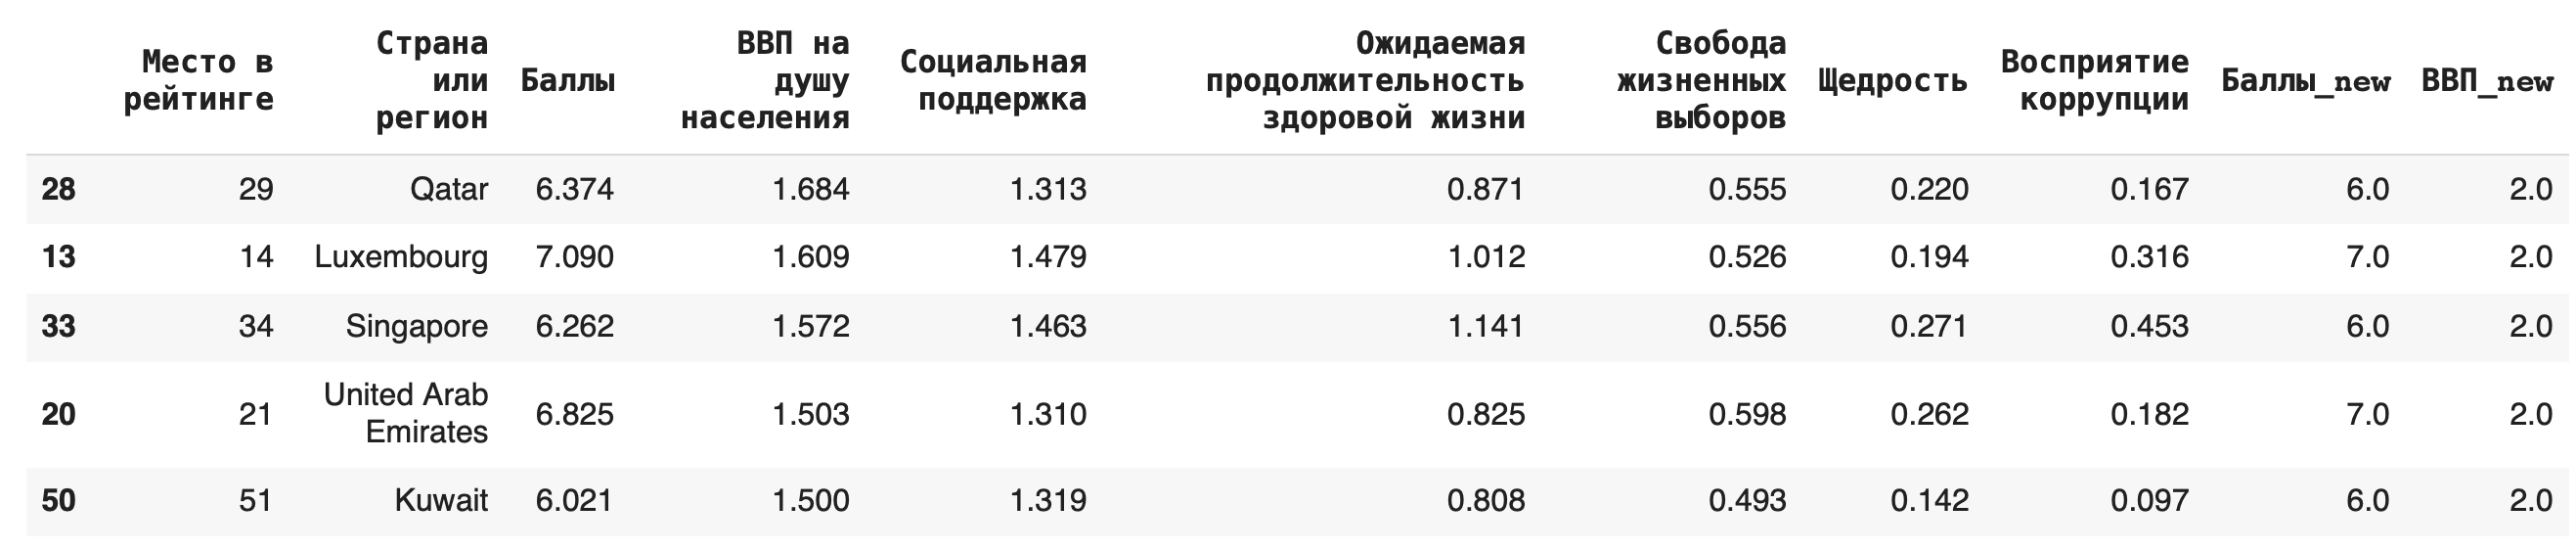
Видно, что самые высокие ВВП совсем не гарантируют высокое место в рейтинге.
Чтобы сделать сортировку по убыванию, можно воспользоваться параметром ascending (от англ. «по возрастанию») = False: df.sort_values(by = ‘ВВП на душу населения’, ascending=False)
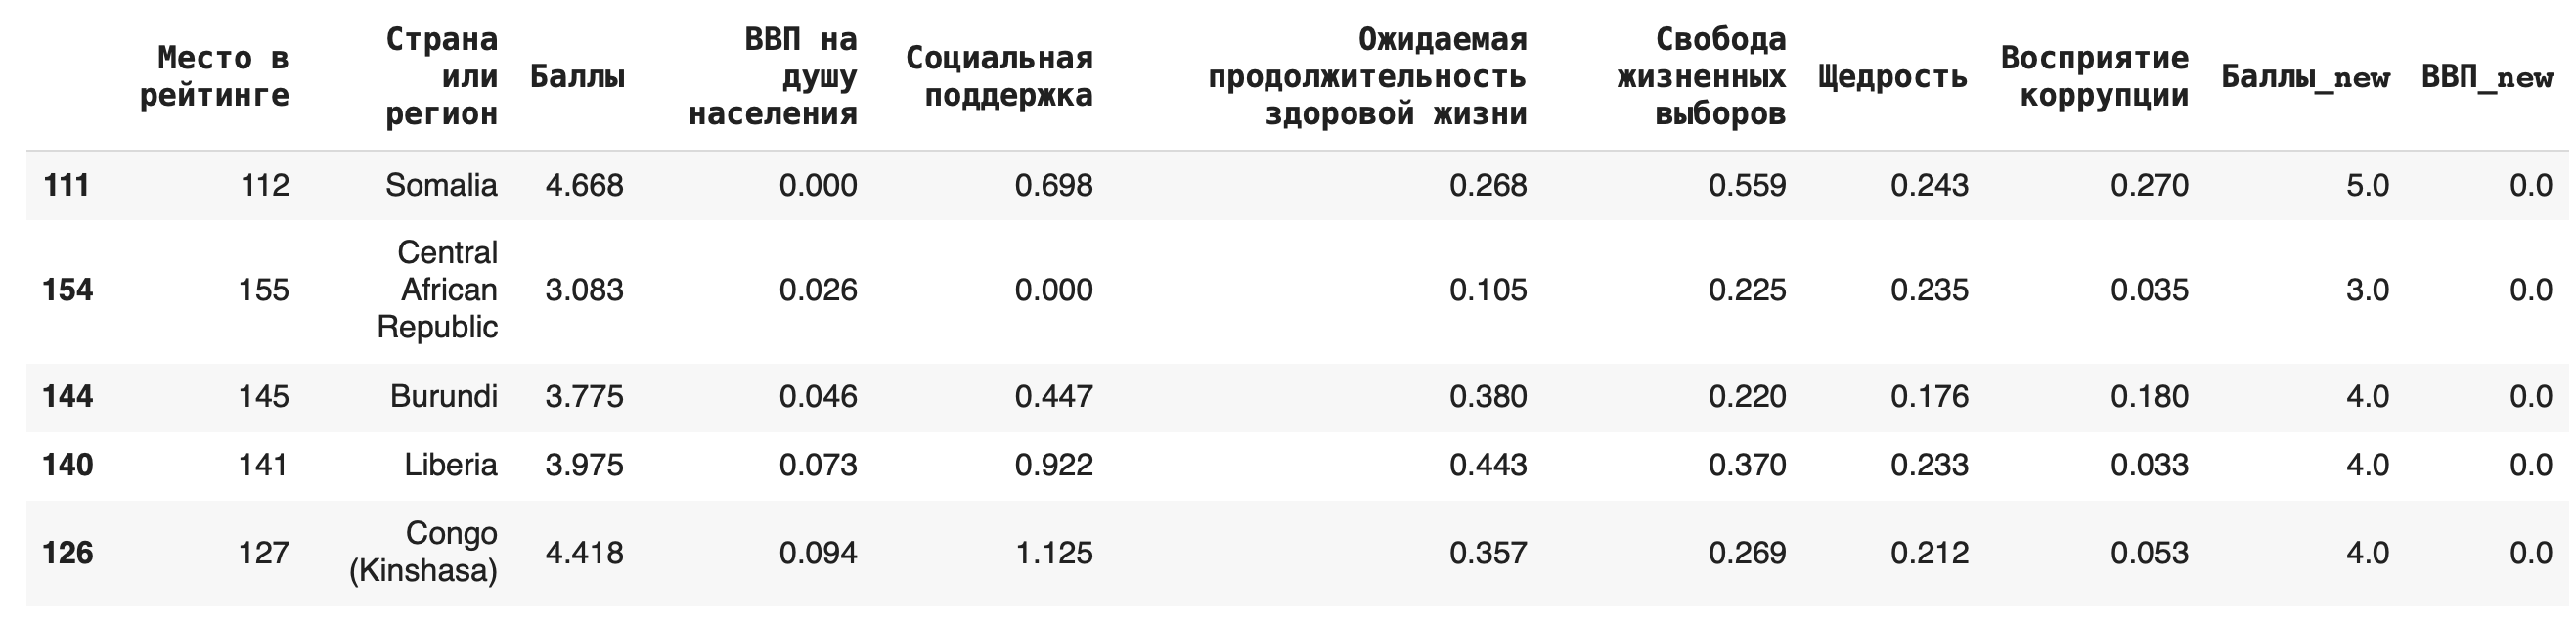
Фильтрация
Иногда бывает нужно получить строки, удовлетворяющие определенному условию; для этого используется «фильтрация» датафрейма. Условия могут быть самые разные, рассмотрим несколько примеров и их синтаксис:
1) Получение строки с конкретным значением какого-либо столбца (выведем строку из датасета для Норвегии): df[df[‘Страна или регион’] == ‘Norway’]

2) Получение строк, для которых значения в некотором столбце удовлетворяют неравенству. Выведем строки для стран, у которых «Ожидаемая продолжительность здоровой жизни» больше единицы:
df[df[‘Ожидаемая продолжительность здоровой жизни’] > 1]
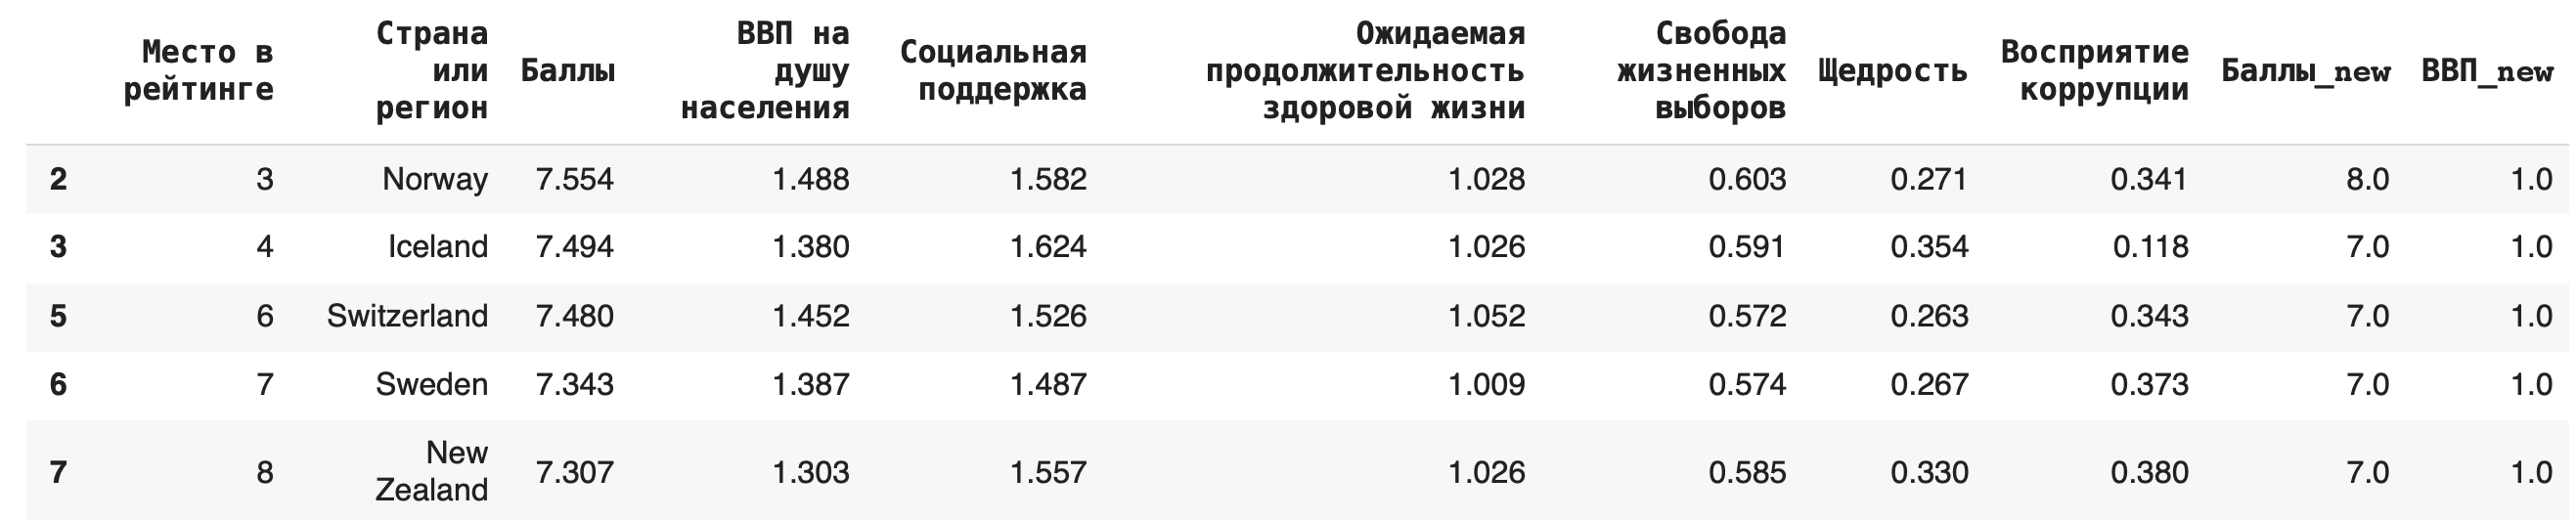
3) В условиях фильтрации можно использовать не только математические операции сравнения, но и методы работы со строками. Выведем строки датасета, названия стран которых начинаются с буквы F, — для этого воспользуемся методом .startswith():
df[df[‘Страна или регион’].str.startswith(‘F’)]
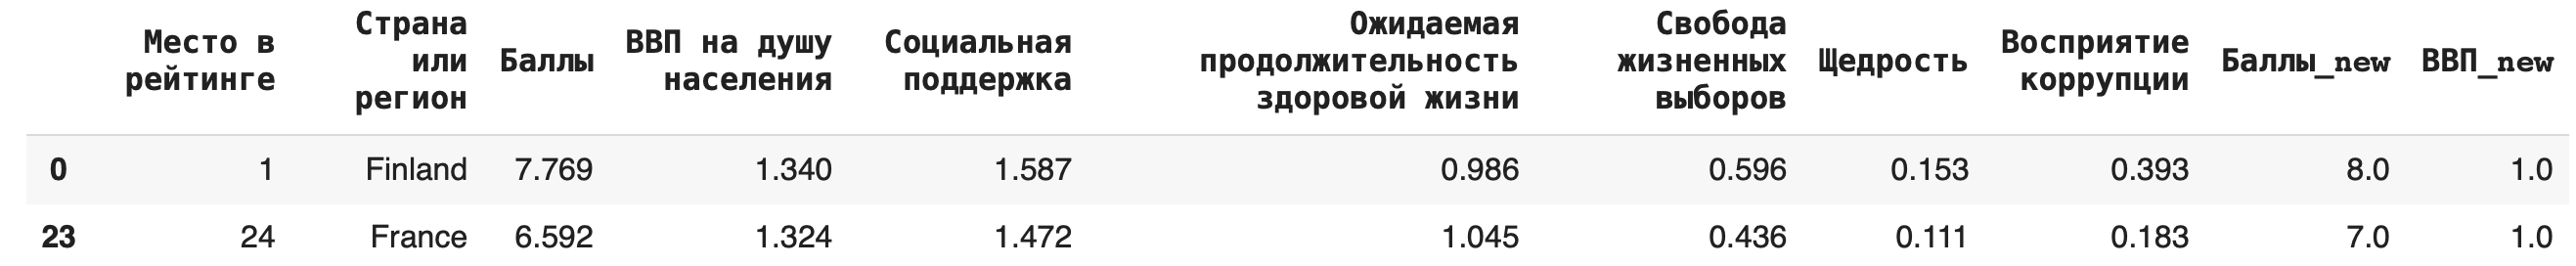
4) Можно комбинировать несколько условий одновременно, используя логические операторы. Выведем строки, в которых значение ВВП больше 1 и уровень социальной поддержки больше 1,5: df[(df[‘ВВП на душу населения’] > 1) & (df[‘Социальная поддержка’] > 1.5)]
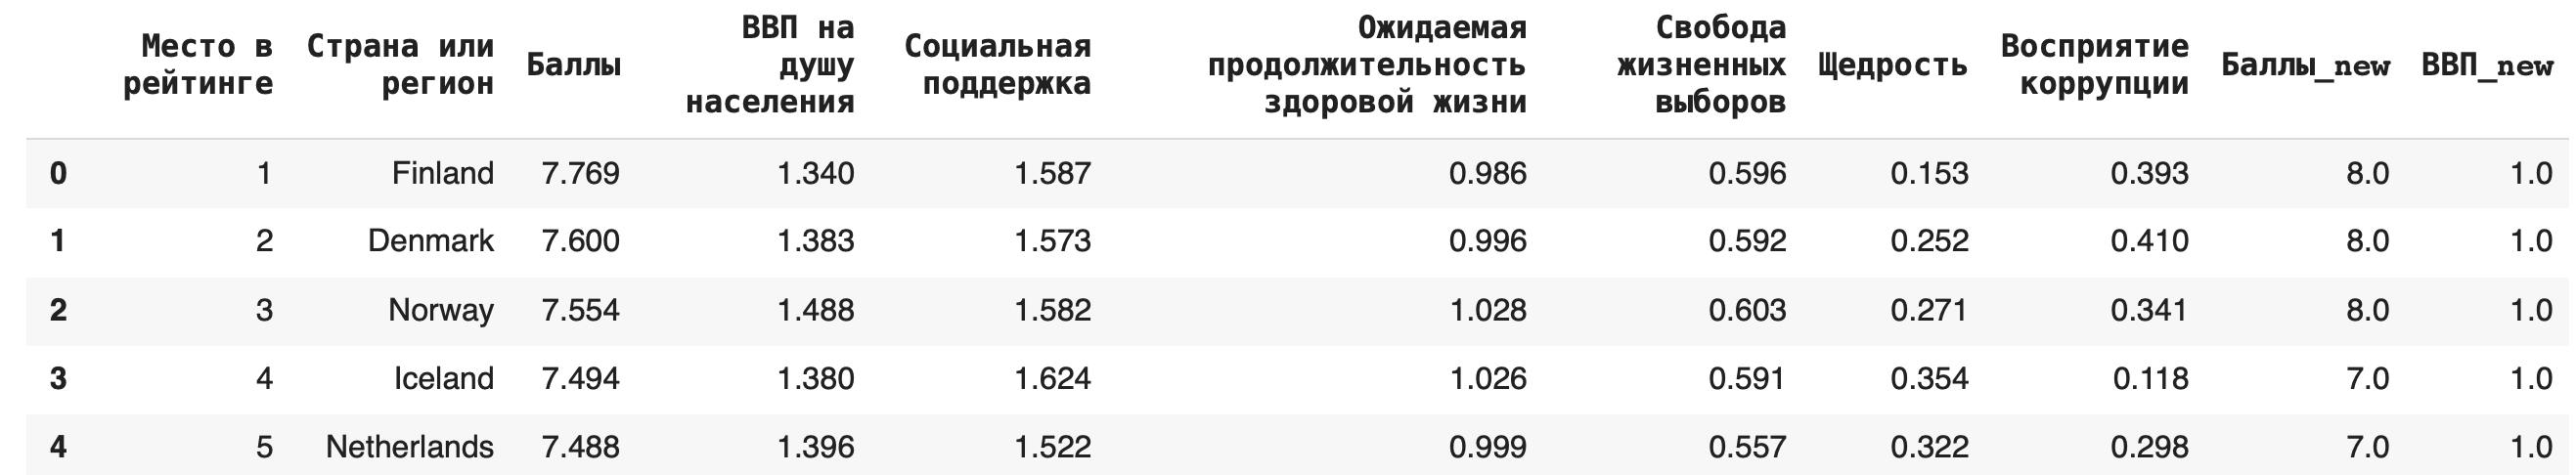
Таким образом, если внутри внешних квадратных скобок стоит истинное выражение, то строка датасета будет удовлетворять условию фильтрации. Поэтому в других ситуациях можно использовать в условии фильтрации любые функции/конструкции, возвращающие значения True или False.
Применение функций к столбцам
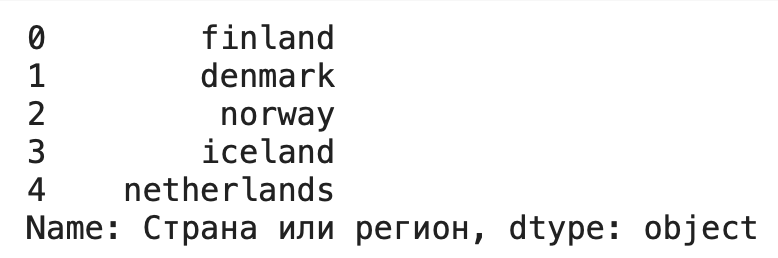
Зачастую встроенных функций и методов для датафреймов из библиотеки бывает недостаточно для выполнения той или иной задачи. Тогда мы можем написать свою собственную функцию, которая преобразовывала бы строку датасета как нам нужно, и затем использовать метод .apply() для применения этой функции ко всем строкам нужного столбца.
Рассмотрим пример: напишем функцию, которая преобразует все буквы в строке к нижнему регистру, и применим к столбцу стран и регионов: def my_lower(row): return row.lower() df[‘Страна или регион’].apply(lower)
Очистка данных
Это целый этап работы с данными при подготовке их к построению моделей и нейронных сетей. Рассмотрим основные приемы и функции.
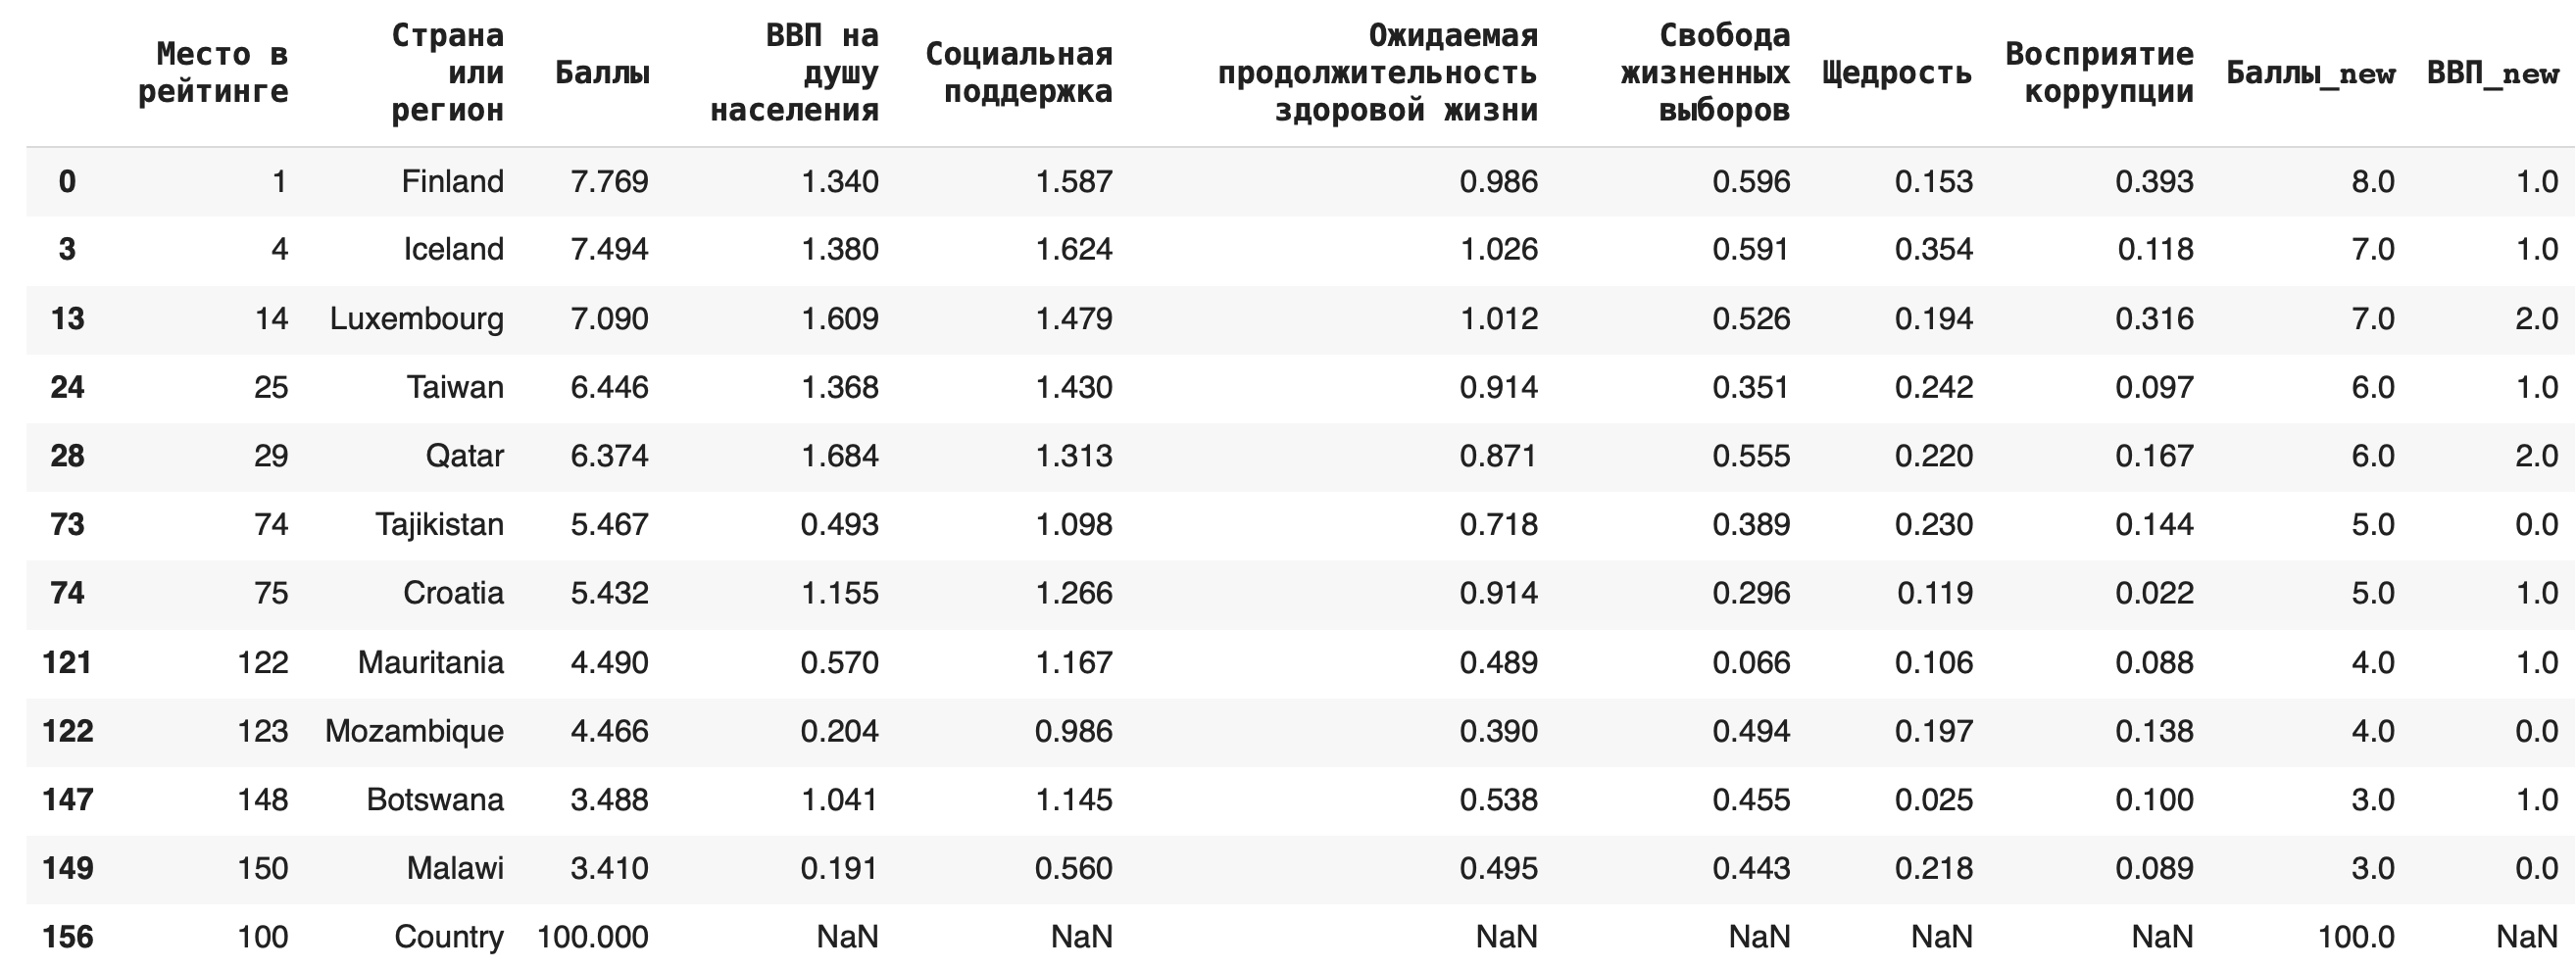
1) Удаление дубликатов из датасета делается при помощи функции drop_duplucates(). По умолчанию удаляются только полностью идентичные строки во всем датасете, но можно указать в параметрах и отдельные столбцы. Например, после округления у нас появились дубликаты в столбцах «ВВП_new» и «Баллы_new», удалим их: df_copied = df.copy() df_copied.drop_duplicates(subset = [‘ВВП_new’, ‘Баллы_new’])
Этот метод не требует дополнительного присваивания в исходную переменную, чтобы результат сохранился, — поэтому предварительно создадим копию нашего датасета, чтобы не форматировать исходный.
Строки-дубликаты удаляются полностью, таким образом, их количество уменьшается. Чтобы заменить их на пустые, можно использовать параметр inplace = True. df_copied.drop_duplicates(subset = [‘ВВП_new’, ‘Баллы_new’], inplace = True)
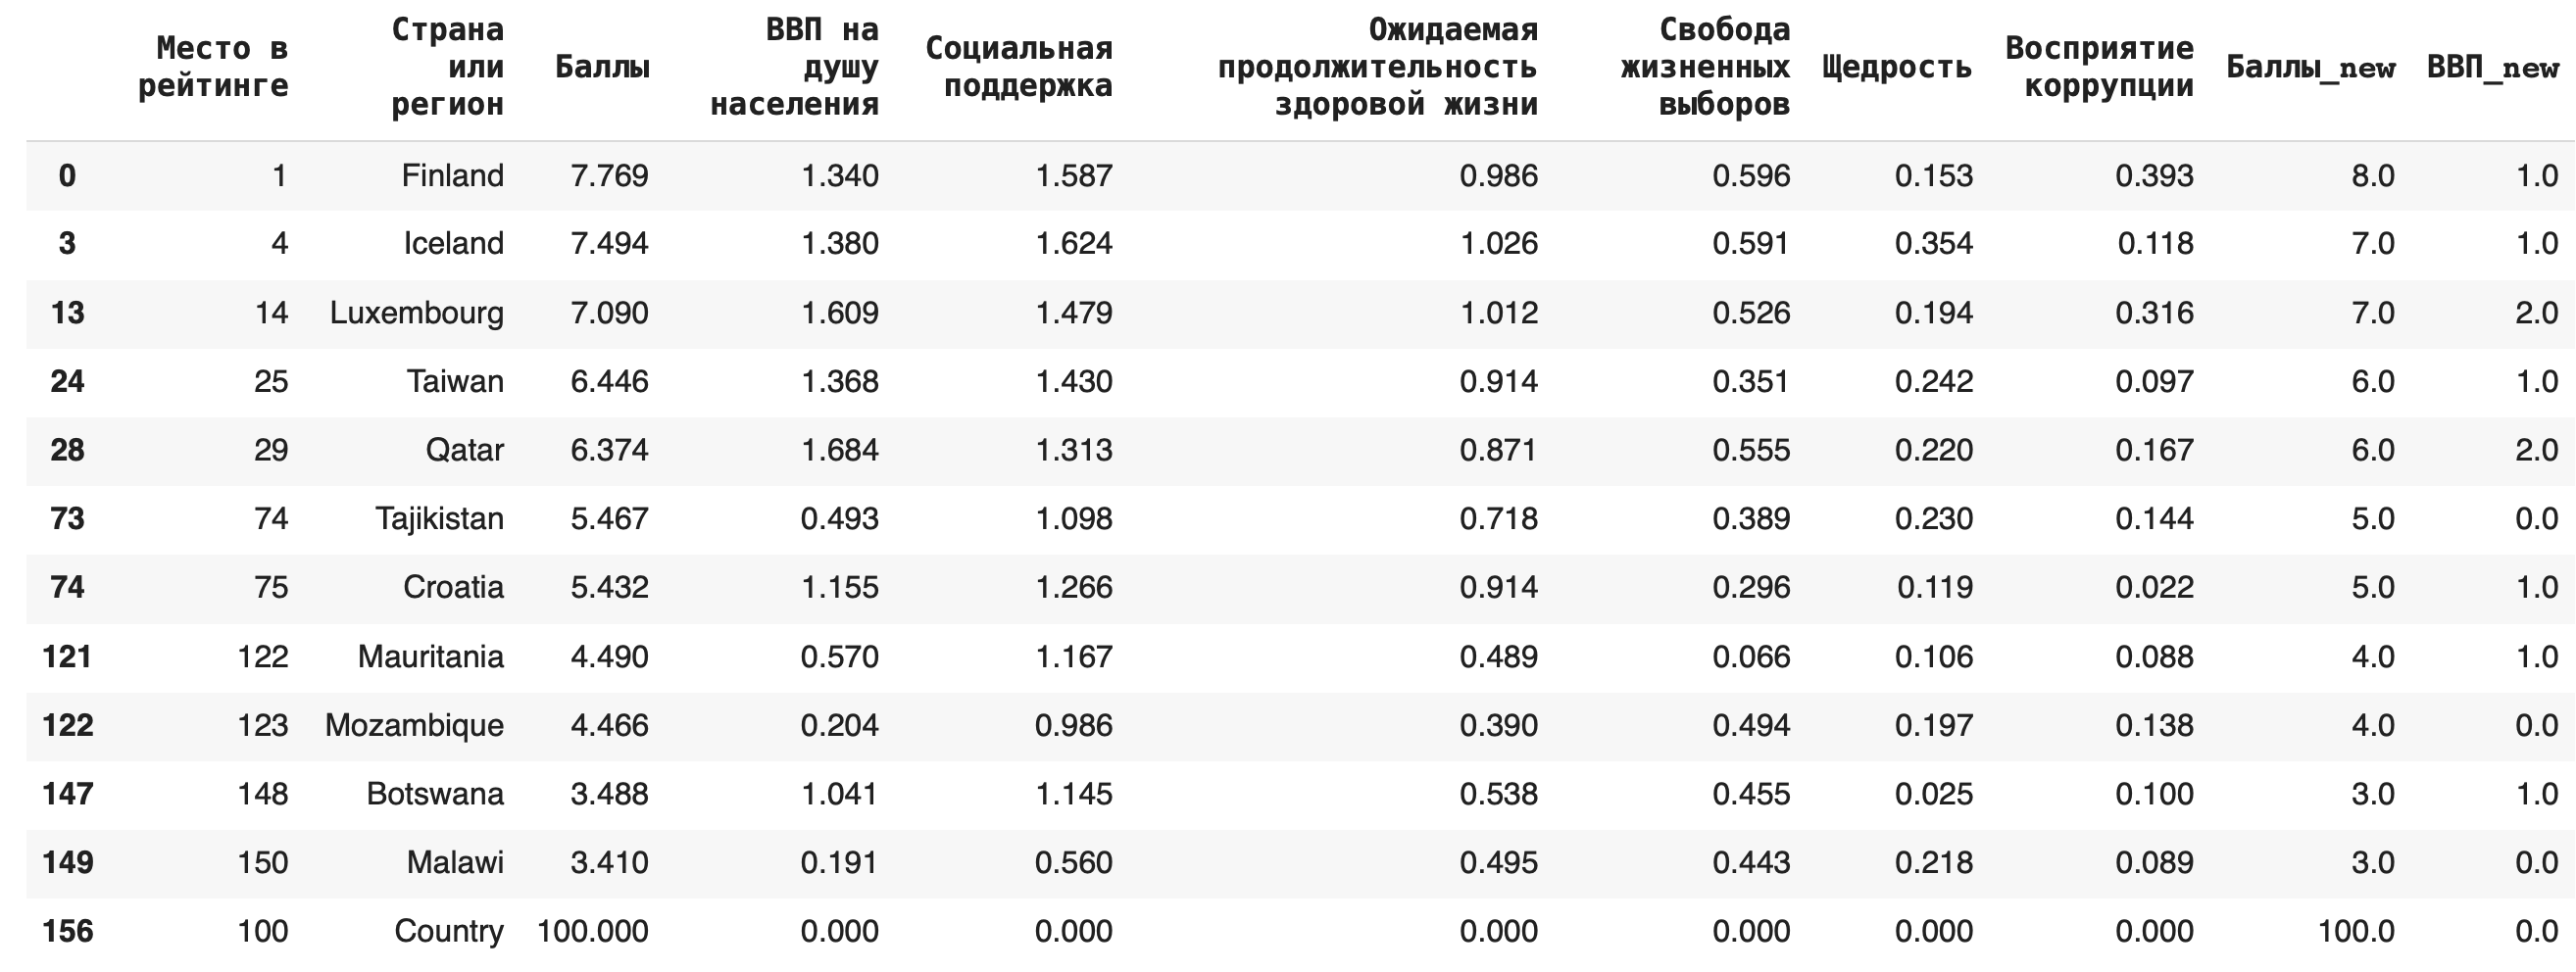
2) Для замены пропусков NaN на какое-либо значение используется функция fillna(). Например, заполним появившиеся после предыдущего пункта пропуски в последней строке нулями: df_copied.fillna(0)
3) Пустые строки с NaN можно и вовсе удалить из датасета, для этого используется функция dropna() (можно также дополнительно указать параметр inplace = True): df_copied.dropna()
Построение графиков
В Pandas есть также инструменты для простой визуализации данных.
1) Обычный график по точкам.
Построим зависимость ВВП на душу населения от места в рейтинге: df.plot(x = ‘Место в рейтинге’, y = ‘ВВП на душу населения’)
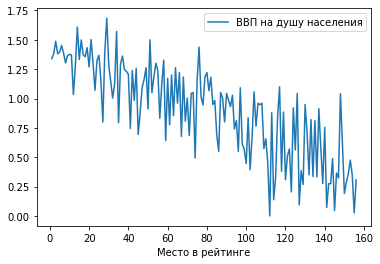
2) Гистограмма.
Отобразим ту же зависимость в виде столбчатой гистограммы: df.plot.hist(x = ‘Место в рейтинге’, y = ‘ВВП на душу населения’)
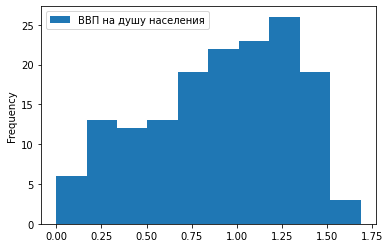
3) Точечный график.
df.plot.scatter(x = ‘Место в рейтинге’, y = ‘ВВП на душу населения’)
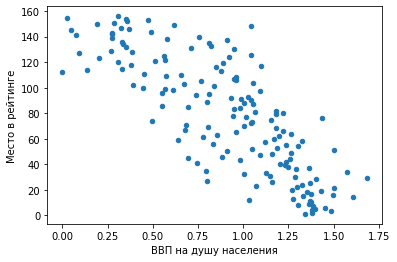
Мы видим предсказуемую тенденцию: чем выше ВВП на душу населения, тем ближе страна к первой строчке рейтинга.
Сохранение датафрейма на компьютер
Сохраним наш датафрейм на компьютер: df.to_csv(‘WHR_2019.csv’)
Теперь с ним можно работать и в других программах.
Блокнот с кодом можно скачать здесь (формат .ipynb).
Мария Жарова Эксперт по Python и математике для Data Science, ментор одного из проектов на курсе по Data Science.
Создаем свой датасет с пришельцами
Сегментацией людей с помощью нейронных сетей уже никого не удивишь. Есть много приложений, таких как Sticky Ai, Teleport Live, Instagram, которые позволяют выполнять такую сложную задачу на мобильном телефоне в реалтайме.
Итак, предположим планета Земля столкнулась с внеземными цивилизациями. И от пришельцев из звездной системы Альфа Центавра поступает запрос на разработку нового продукта. Им очень понравилось приложение Sticky Ai, которое позволяет вырезать людей и делать стикеры, поэтому они хотят портировать приложение на свой межгалактический рынок.
К сожалению, наша нейронная сеть, которая используется в приложении для сегментации, обучена только на изображениях человеческой расы, поэтому на пришельцах работает плохо. Срочно возникает потребность расширить наш датасет пришельцами.
Попросив у пришельцев несколько тысяч их изображений, мы приступаем к разметке.
Задача:
Есть изображения пришельцев, для каждого изображения надо создать черно-белую маску, в которой белым будет выделен пришелец, а черным фон.
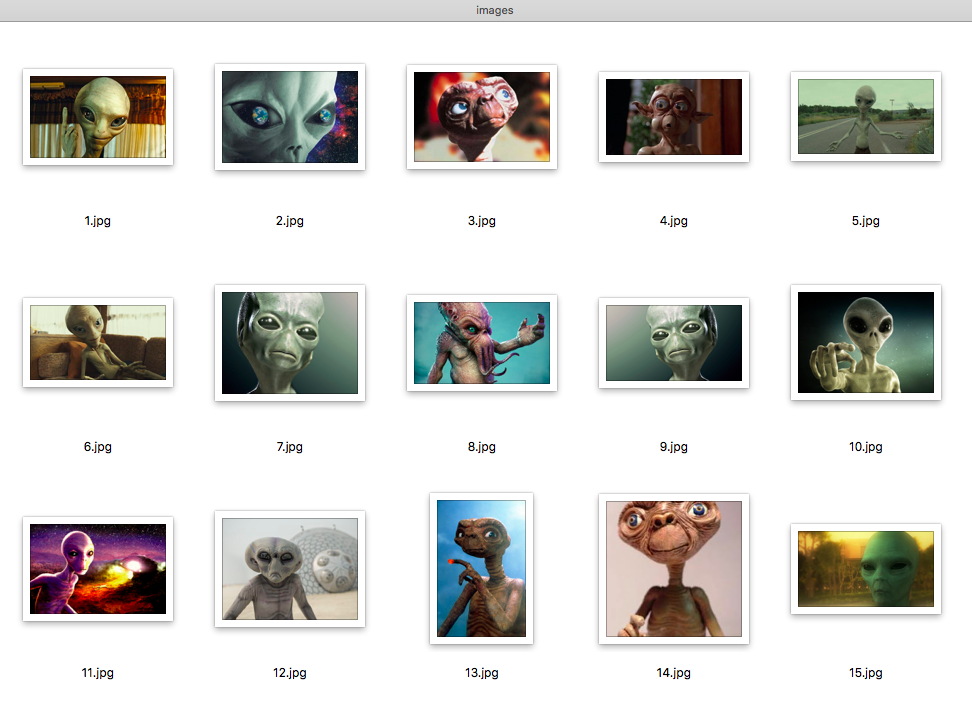
Решение:
Первым делом нужно составить ТЗ для фрилансеров, которые будут размечать изображения. Так как нам нужно очень высокое качество, то будем размечать изображения в фотошопе.
Спойлер
Если очень хорошее качество нам не нужно, либо выделяемый объект очень простой, то такую разметку можно производить с помощью ломаных линий (polygon vertices). Такой тип разметки доступен на Amazon Mechanical Turk и Яндекс.Толоке, где рабочая сила очень дешевая.
Можно составить ТЗ в виде 10-ти страничного PDF документа, но:
- Фрилансеры обычно не читают ТЗ, а пролистывают.
- В документе сложно описать подробно алгоритм как правильно и быстро надо размечать.
- На составление самого документа уходит очень много времени.
Поэтому сейчас мы полностью отказались от ТЗ в виде PDF документа, а предоставляем задание в
виде обучающего видео. После такого нововведения:
- В 2 раза выросла производительность фрилансеров (так как в видео представлен самый быстрый и оптимальный способ разметки).
- В 3 раза сократились вопросы, задаваемые фрилансерами (так как на видео показан каждый шаг).
- В 2 раза получилось уменьшить стоимость разметки (так как цена часа работы не изменилась, но фрилансеры размечают в два раза быстрее).
Особое внимание надо уделить методу разметки в фотошопе. Фотошоп — очень гибкая программа, в которой производить разметку можно разными способами. Поэтому желательно заранее определить какое качество разметки вам нужно, изучить разные инструменты выделения, сравнить их между собой и выбрать тот, с помощью которого обработка изображения происходит быстрее всего.
Пример:
Есть два способа выделения:
Способ А занимает 5 мин на изображение.
Способ Б занимает 10 мин на изображение.
При способе А за час фрилансер размечает 12 изображений, поэтому цена за изображение будет 150 / 12 = 12.5 руб.
При способе Б за час фрилансер размечает 6 изображений, поэтому цена за изображение будет 150 / 6 = 25 руб.
Итак, мы нашли лучший способ выделения и записали видеоинструкцию, что дальше?
Осталось найти фрилансеров. Есть много бирж фрилансеров, таких как Fl.ru, Weblancer, Фриланс.ру.
Но в последнее время мы используем фриланс-биржу WORK-ZILLA, потому что:
- Там довольно дешевая рабочая сила.
- Много исполнителей.
- Удобный интерфейс для создания заданий.
Для того, чтобы создать задание:
Регистрируемся, пополняем баланс, нажимаем «Дать задание», выбираем «Дизайн»->»Обработка фото».

Заполняем заголовок и описание, определяем время на выполнение задания. Обработав несколько пришельцев, я заметил, что на одно изображение в среднем уходит 4 минуты. Т.е. за час выходит 15 изображений, поэтому устанавливаем цену за одно изображение 150 / 15 = 10 руб.

Сразу после публикации задания исполнители начинают предлагать свои услуги.
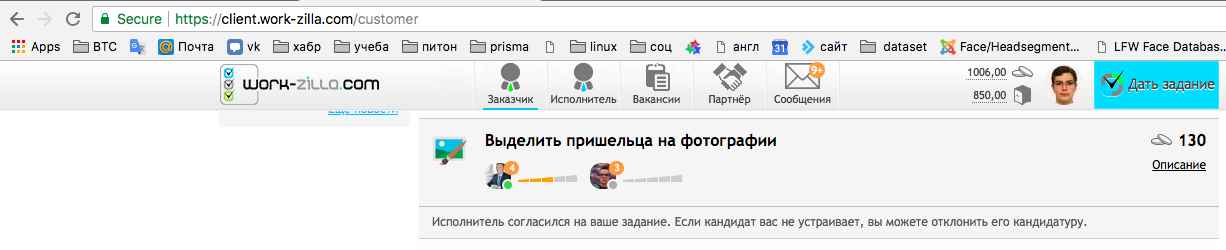
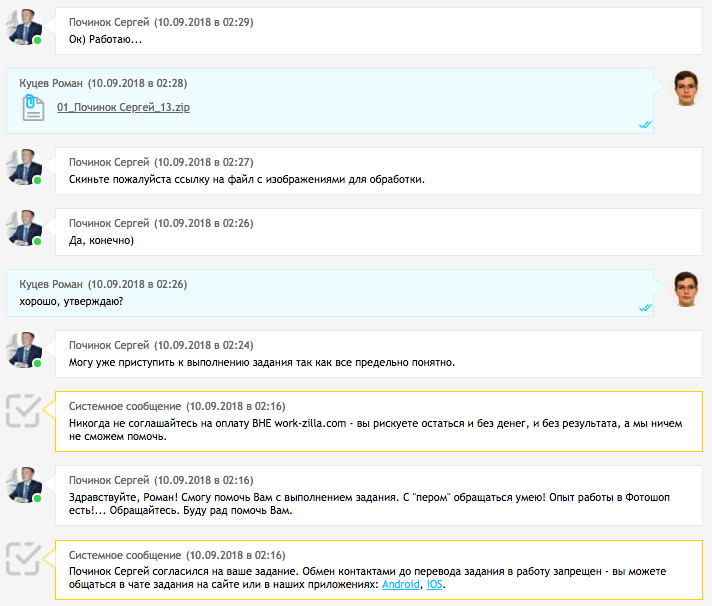
Выбираем самого красивого по аватарке опытного по отзывам и утверждаем в качестве исполнителя, выдаем изображения. Как видим, поиск фрилансера у нас занял менее 15 минут.
На следующее утро исполнитель прислал работу.
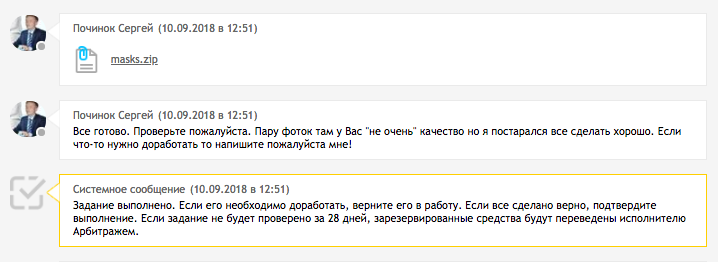
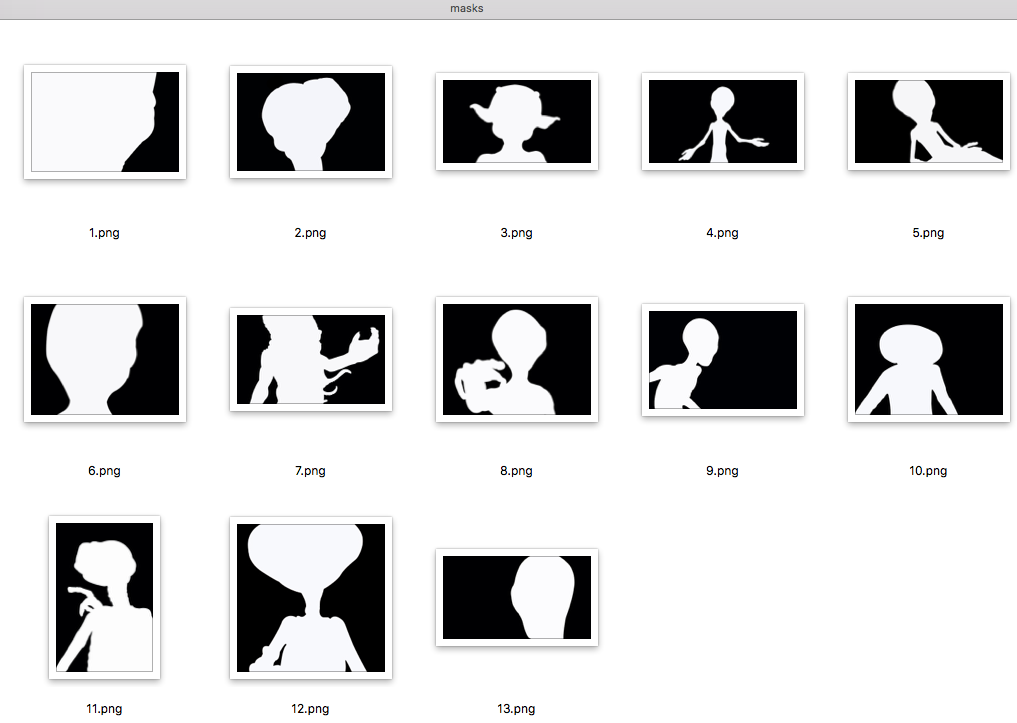
Как теперь ее проверить?
Конечно, можно каждое изображение открыть в фотошопе и посмотреть насколько хорошо все выделено, но что делать, если на тебя одновременно работает 20 человек, и каждый присылает по 40 изображений в день?
Автоматизировать! Для облегчения проверки мною был реализован на питоне такой скрипт:
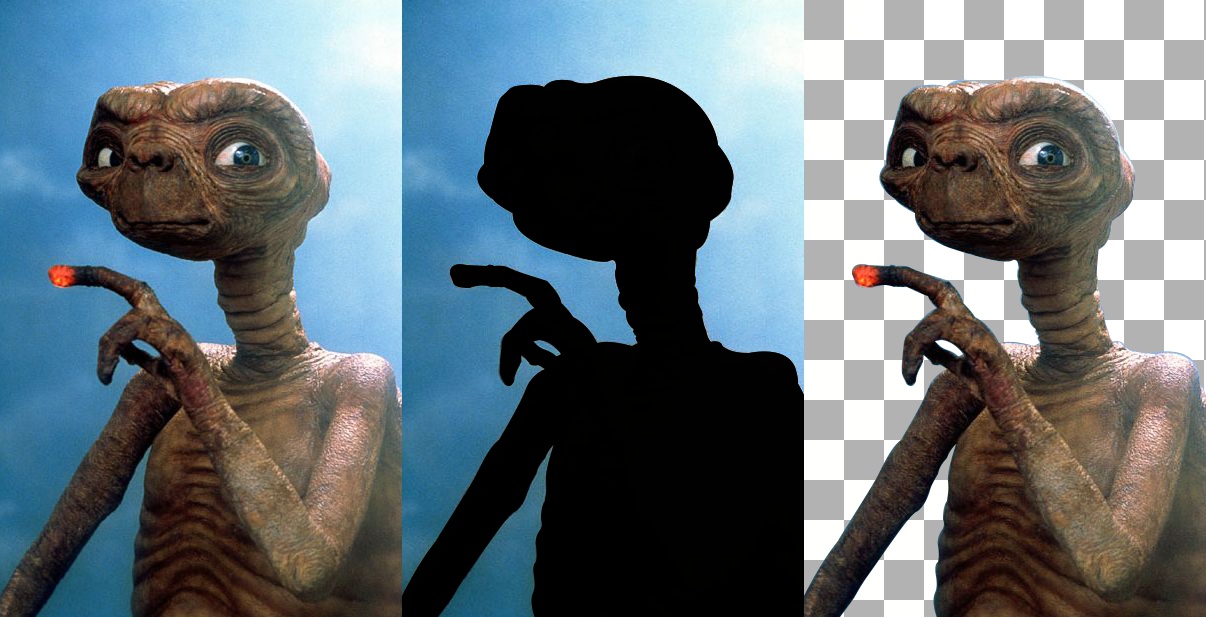
import cv2 import numpy as np import os import shutil from __future__ import print_function from tqdm import tqdm_notebook as tqdm #функция, которая рисует фон как в фотошопе def generate_checkerboard(shape, size): res = np.ones(shape, dtype=np.float32) for i in range(0, shape[0] // size + 1): for j in range(0, shape[1] // size + 1): if (i + j) % 2 == 0: res[i * size:i * size + size, j * size:j * size + size] = 0.7 return np.stack([res] * 3, axis=2) path = '01_Починок Сергей_13' files_im = filter(lambda x: x[-4:] == '.jpg', os.listdir(path + '/images')) files_masks = filter(lambda x: x[-4:] == '.png', os.listdir(path + '/masks')) print('Кол-во изображений: %s' % len(files_im)) print('Кол-во масок: %s' % len(files_masks)) if len(files_im) != len(files_masks): print('Кол-во изображений и масок не совпадает') raise Exception('bad count') #создаем папку res, в которую будут записываться коллажи os.makedirs(path + '/res') for idd in tqdm(map(lambda x: x[:-4], files_im)): print(idd) mask = cv2.imread(path + '/masks/' + idd + ".png") / 255. im = cv2.imread(path + '/images/' + idd + ".jpg") checkerboard = generate_checkerboard(im.shape[:2], 40) * 255 cv2.imwrite(path + '/res/' + idd + ".jpg", np.concatenate([im, im * (1 - mask), im * mask + (1 - mask) * checkerboard],axis=1))Скрипт берет исходное изображение, маску, и делает из них коллаж, состоящий из оригинального изображения, вырезанного фона и вырезанного пришельца.
Запускаем скрипт и получаем такие коллажи:
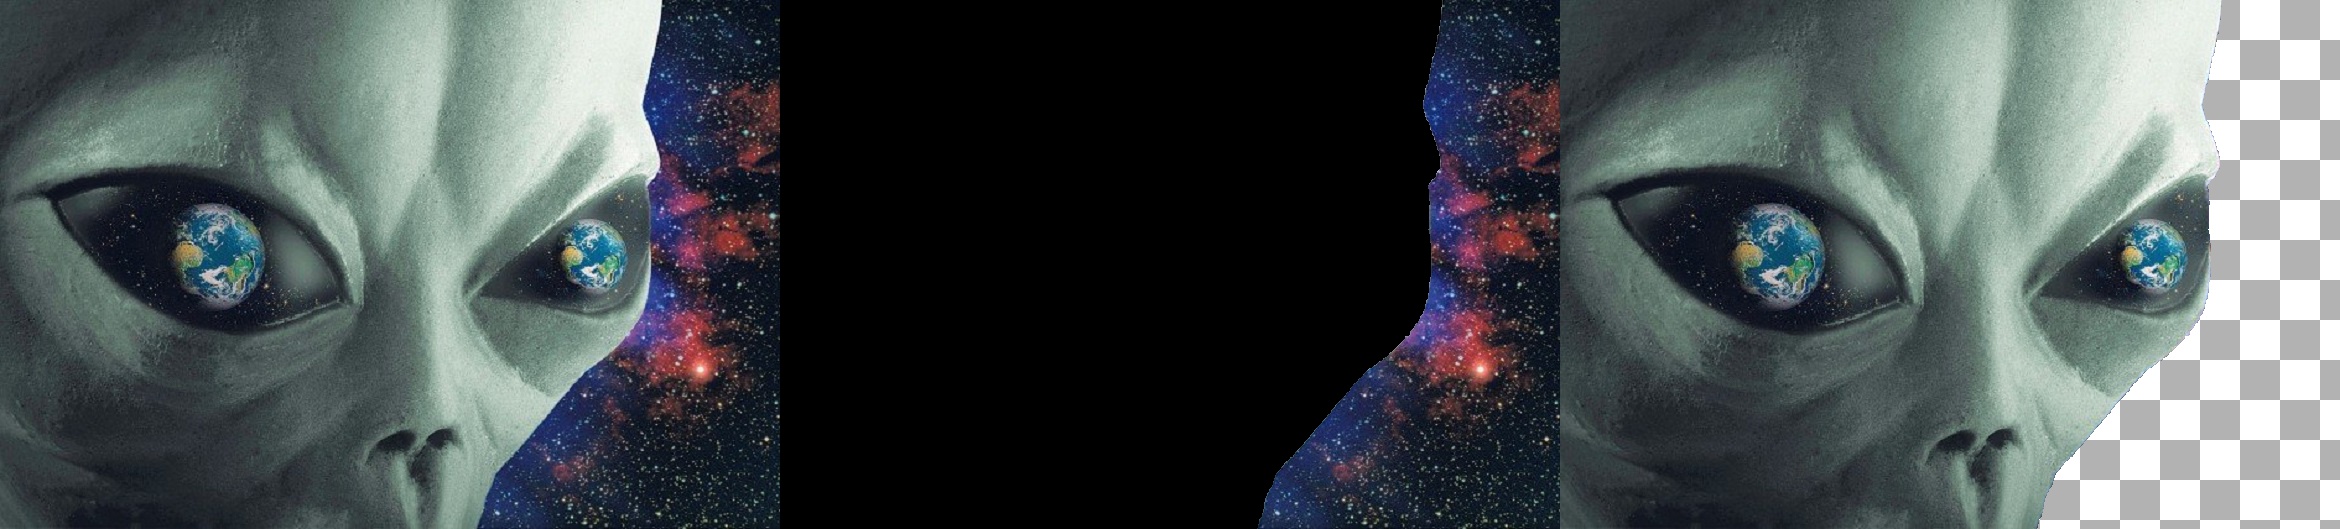
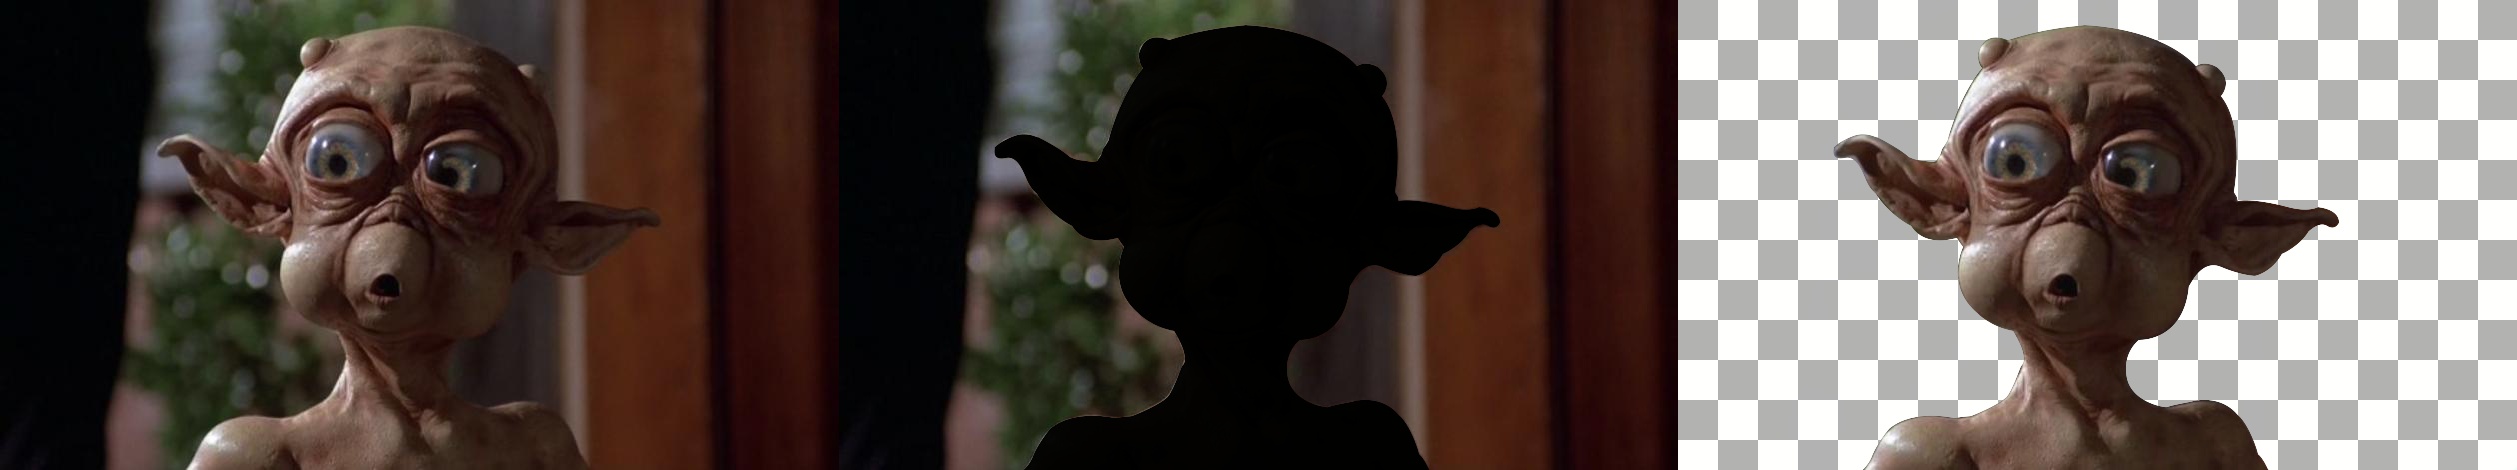
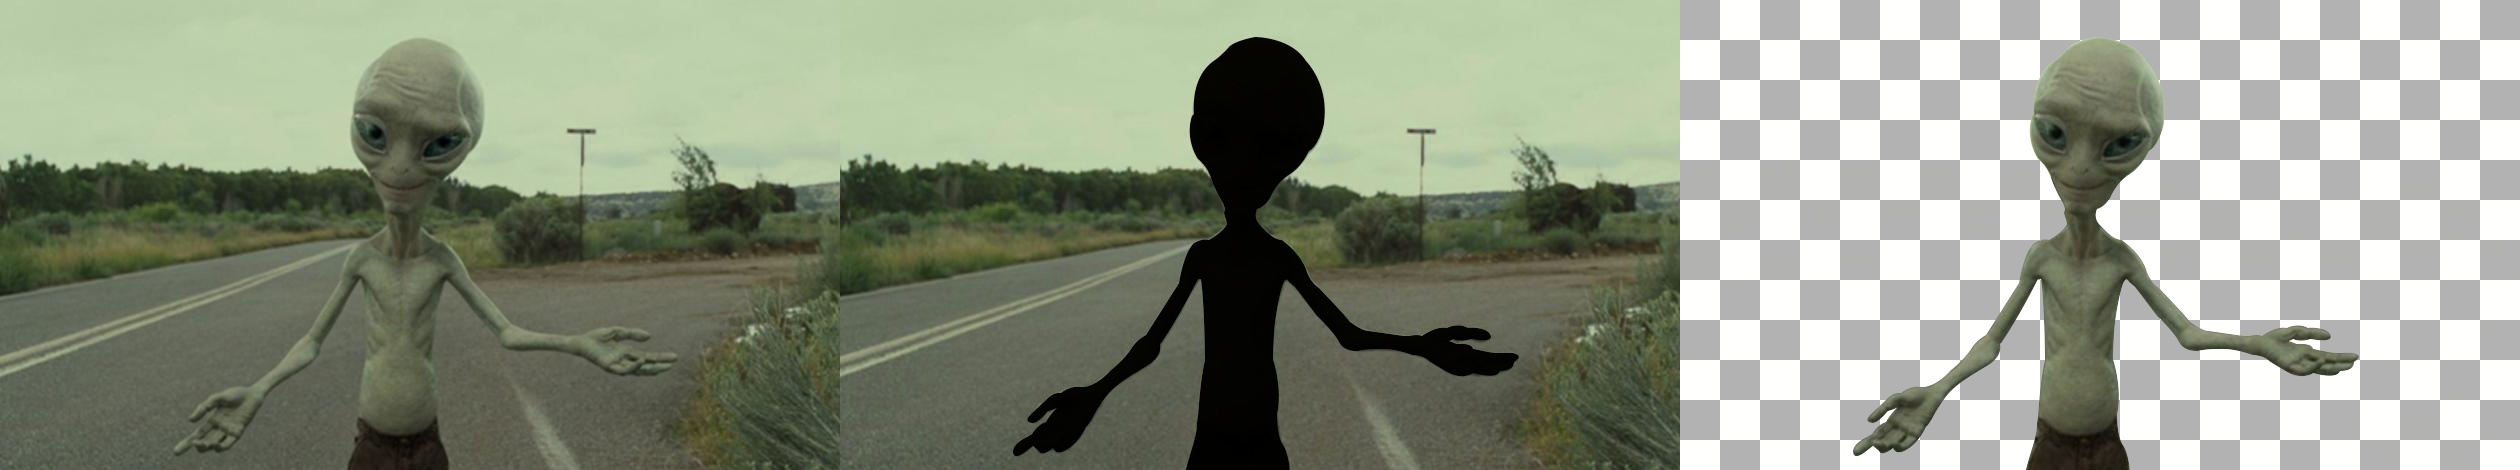
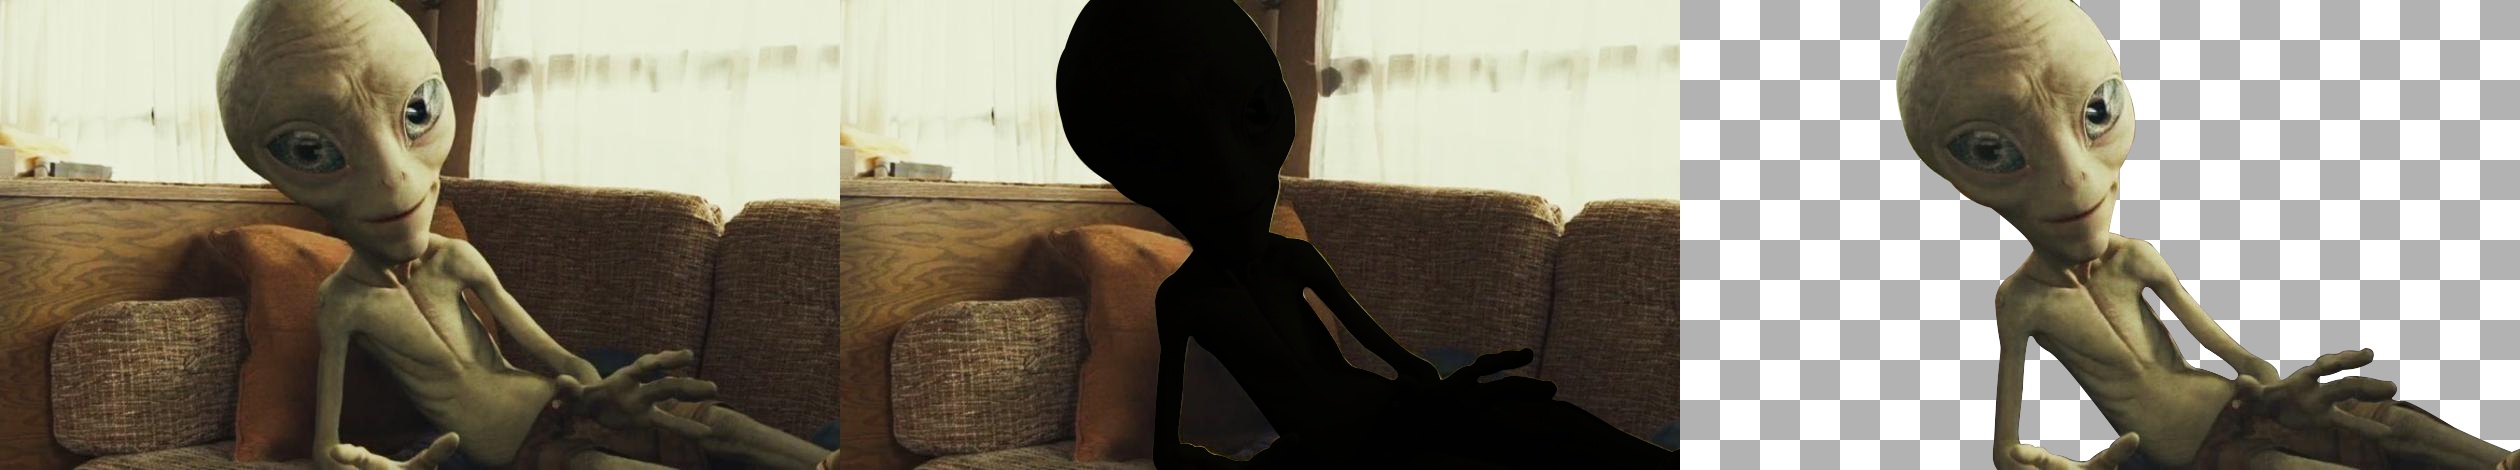
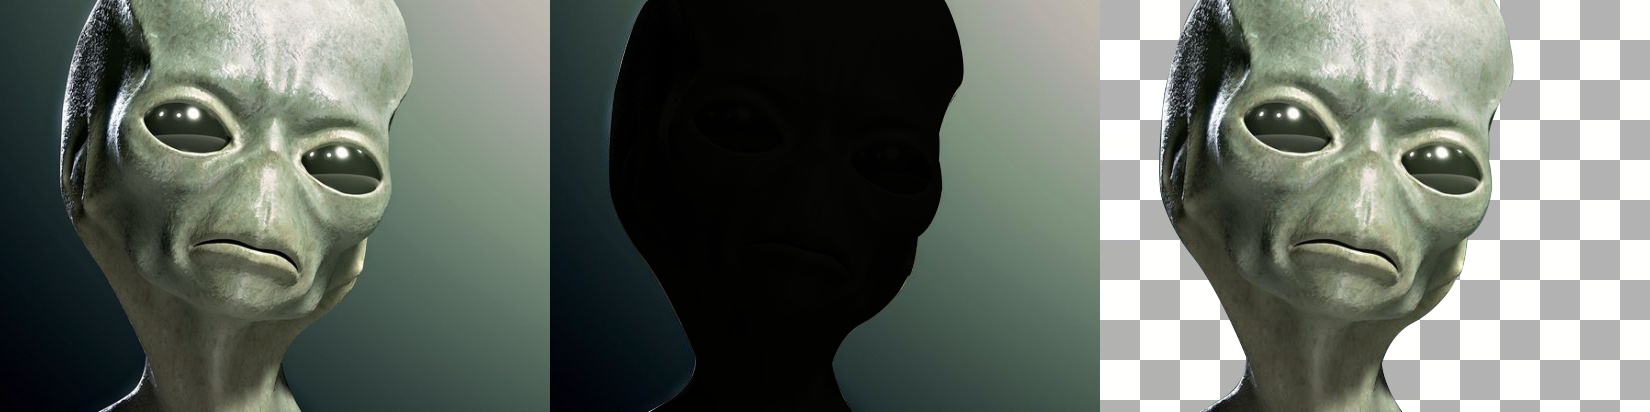
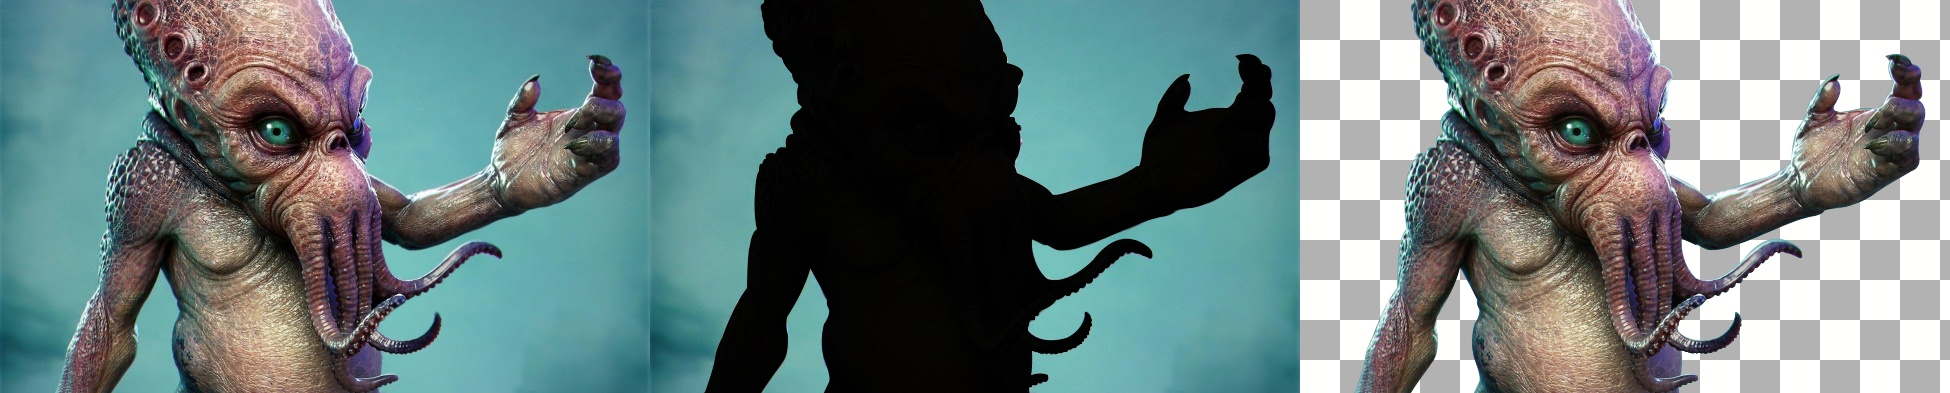
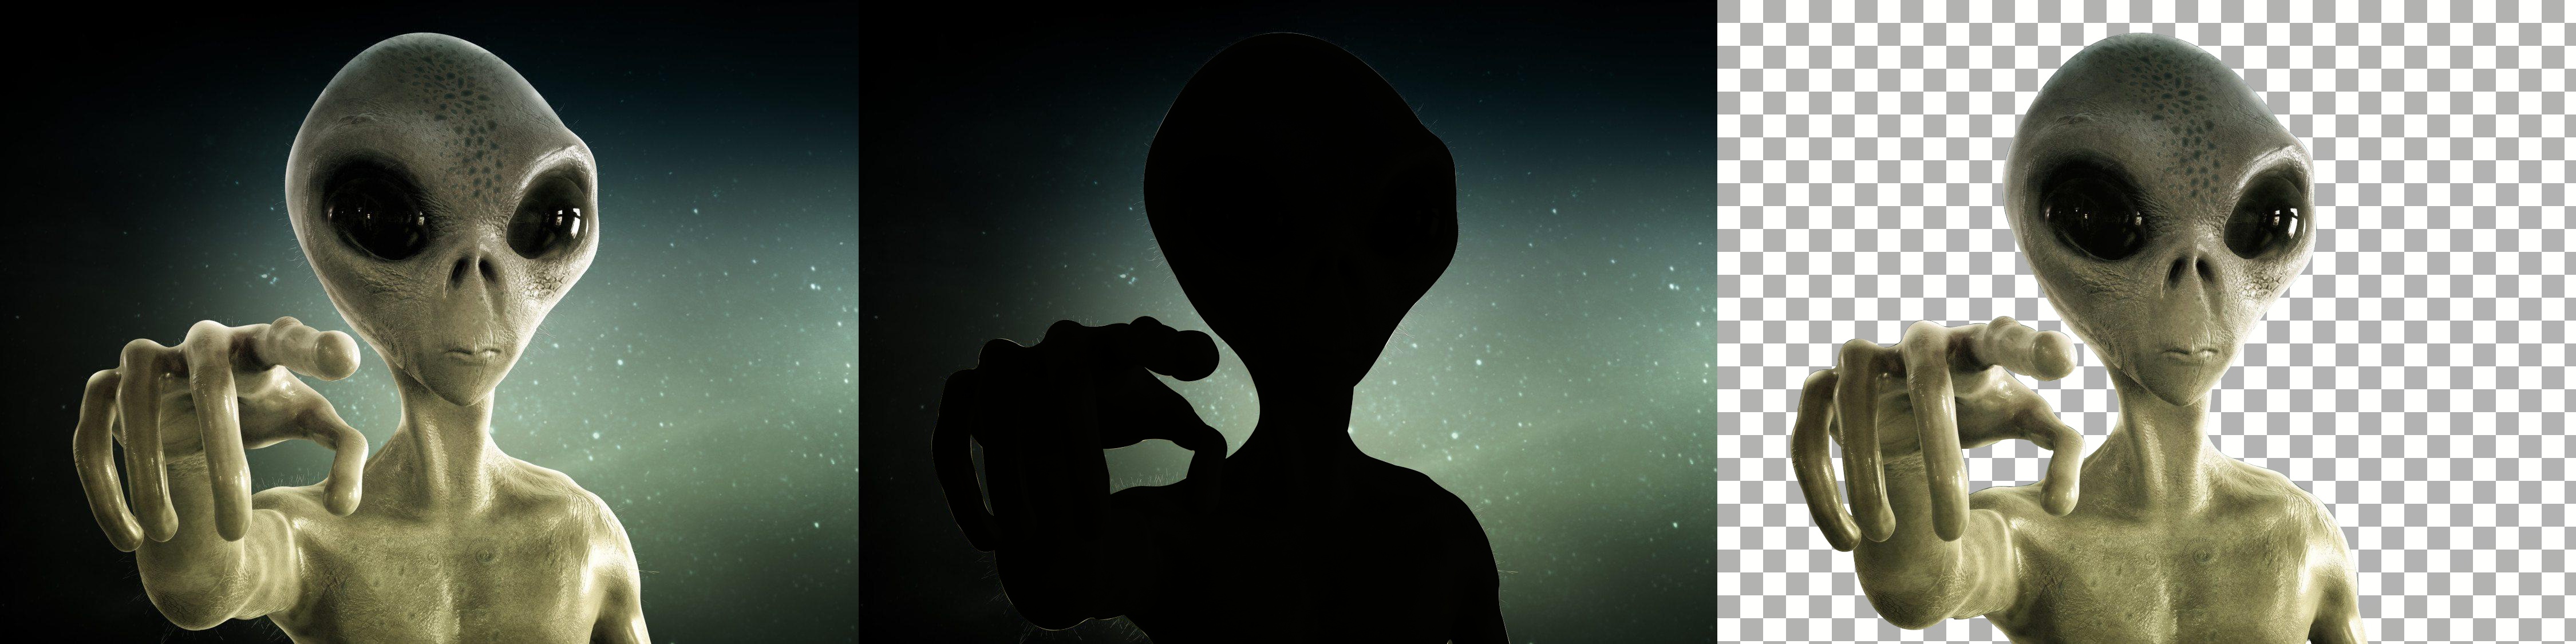
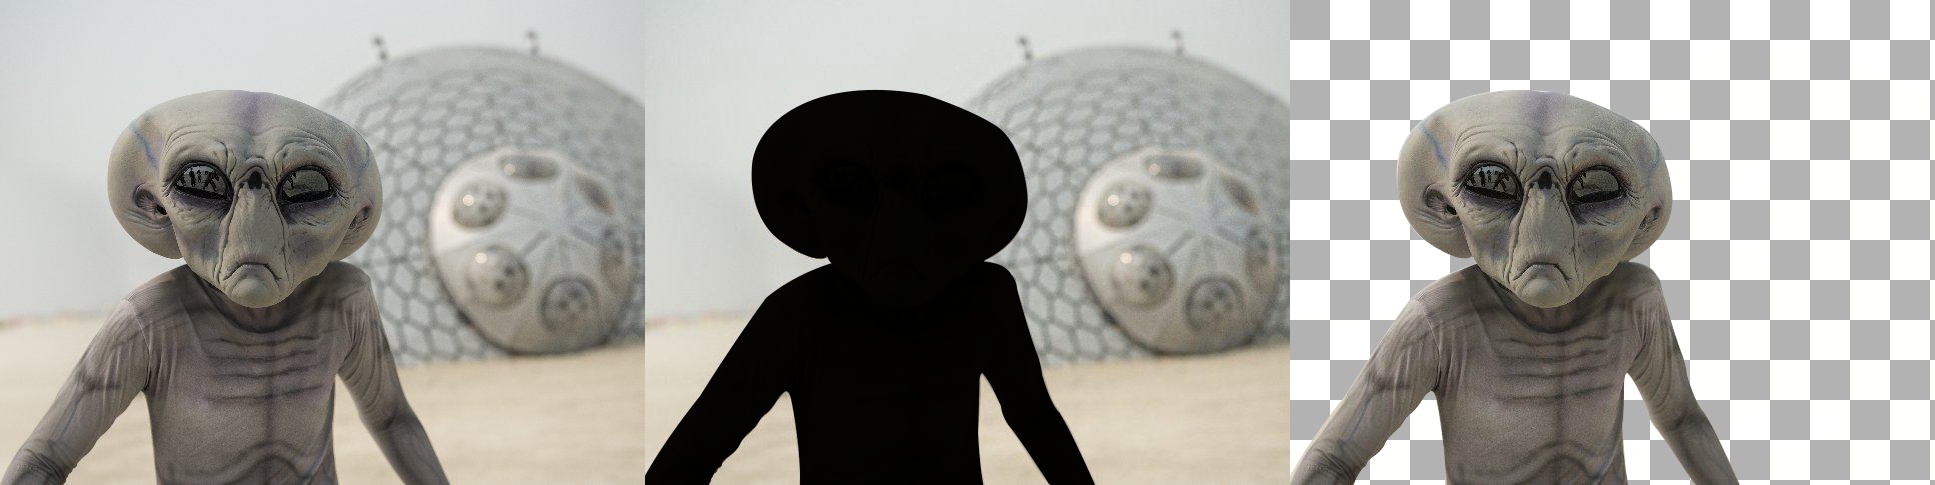

Просмотрев изображения, замечаем, что одно изображение исполнитель выделил не очень хорошо.
Просим подправить изображение.
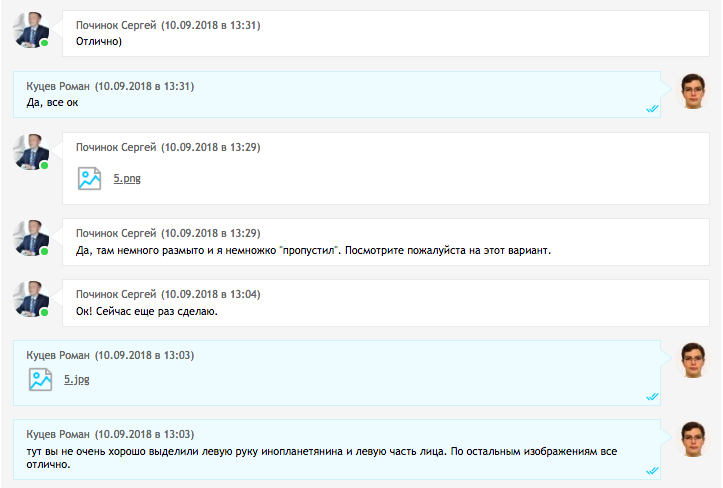
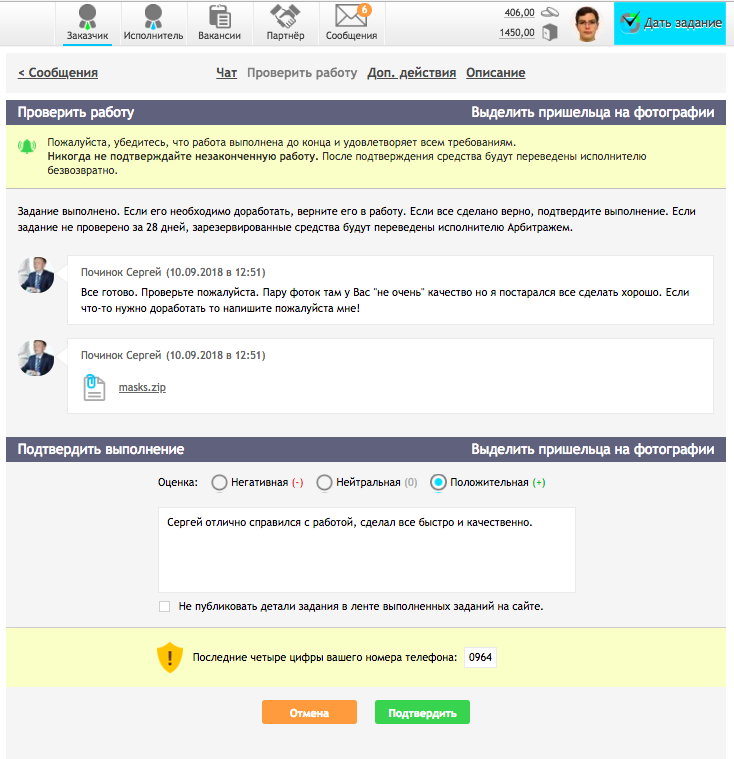
После того, как фрилансер исправил все наши замечания, подтверждаем работу и расписываем благодарный отзыв фрилансеру.
Итог:
Предположим, что для обучения нейронной сети нужно будет 2000 изображений пришельцев.
Тогда, чтобы собрать такой датасет, надо будет потратить всего 2000 х 10 = 20000 руб, а если учесть, что в среднем один фрилансер обрабатывает по 40 изображений в день и одновременно над разметкой трудятся 10 человек, то создание датасета займет 2000 / (10 х 40) = 5 дней.
P.S.
Конечно, мы пока не столкнулись с инопланетянами, никто из команды Prisma AI сегментировать пришельцев не собирается, но на этом примере я хотел показать вам, как просто и с минимальными затратами можно создать свой датасет под любую задачу, будь это детекция пешеходов для беспилотного автомобиля или определение лесов на спутниковых снимках.
- computer vision
- deep learning
- segmentation
- dataset
- фрилансеры
- разметка изображений
- Python
- Data Mining
- Обработка изображений
- Big Data
- Машинное обучение