Как экспортировать Pandas DataFrame в CSV (с примером)
Вы можете использовать следующий синтаксис для экспорта кадра данных pandas в файл CSV:
df.to_csv (r' C:\Users\Bob\Desktop\my_data.csv', index= False ) Обратите внимание, что index=False указывает Python удалить столбец индекса при экспорте DataFrame. Не стесняйтесь отбрасывать этот аргумент, если вы хотите сохранить столбец индекса.
В следующем пошаговом примере показано, как использовать эту функцию на практике.
Шаг 1: Создайте фрейм данных Pandas
Во-первых, давайте создадим DataFrame pandas:
import pandas as pd #create DataFrame df = pd.DataFrame() #view DataFrame df points assists rebounds 0 25 5 11 1 12 7 8 2 15 7 10 3 14 9 6 4 19 12 6 5 23 9 5 Шаг 2: Экспортируйте DataFrame в файл CSV
Далее экспортируем DataFrame в файл CSV:
#export DataFrame to CSV file df.to_csv (r' C:\Users\Bob\Desktop\my_data.csv', index= False ) Шаг 3. Просмотрите CSV-файл
Наконец, мы можем перейти к месту, куда мы экспортировали CSV-файл, и просмотреть его:
points,assists,rebounds 25,5,11 12,7,8 15,7,10 14,9,6 19,12,6 23,9,5 Обратите внимание, что индексного столбца нет в файле, поскольку мы указали index=False .
Также обратите внимание, что заголовки находятся в файле, поскольку аргументом по умолчанию в функции to_csv() является headers=True .
Ради интереса, вот как выглядел бы CSV-файл, если бы мы не указали аргумент index=False :
,points,assists,rebounds 0,25,5,11 1,12,7,8 2,15,7,10 3,14,9,6 4,19,12,6 5,23,9,5 Подробное руководство по функции to_csv() см.в документации pandas .
Pandas: как добавить данные в существующий файл CSV
Вы можете использовать следующий синтаксис в pandas для добавления данных в существующий файл CSV:
df.to_csv('existing.csv', mode='a', index= False , header= False ) Вот как интерпретировать аргументы в функции to_csv() :
- «existing.csv»: имя существующего CSV-файла.
- mode=’a’: используйте режим «добавления» вместо «w» — режима «записи» по умолчанию.
- index=False: не включать столбец индекса при добавлении новых данных.
- header=False: не включать заголовок при добавлении новых данных.
В следующем пошаговом примере показано, как использовать эту функцию на практике.
Шаг 1. Просмотр существующего CSV-файла
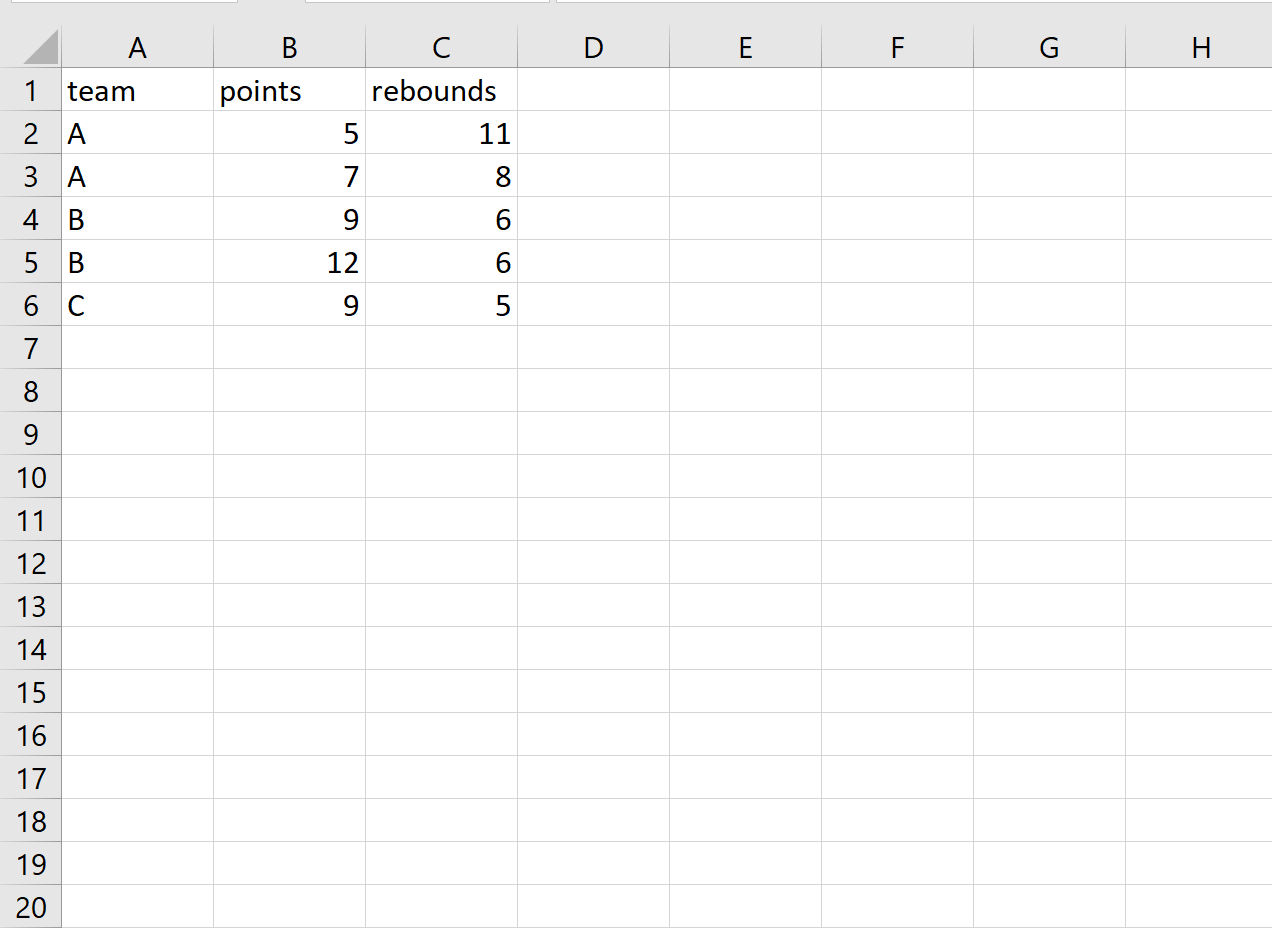
Предположим, у нас есть следующий существующий файл CSV:
Шаг 2: Создайте новые данные для добавления
Давайте создадим новый кадр данных pandas для добавления к существующему файлу CSV:
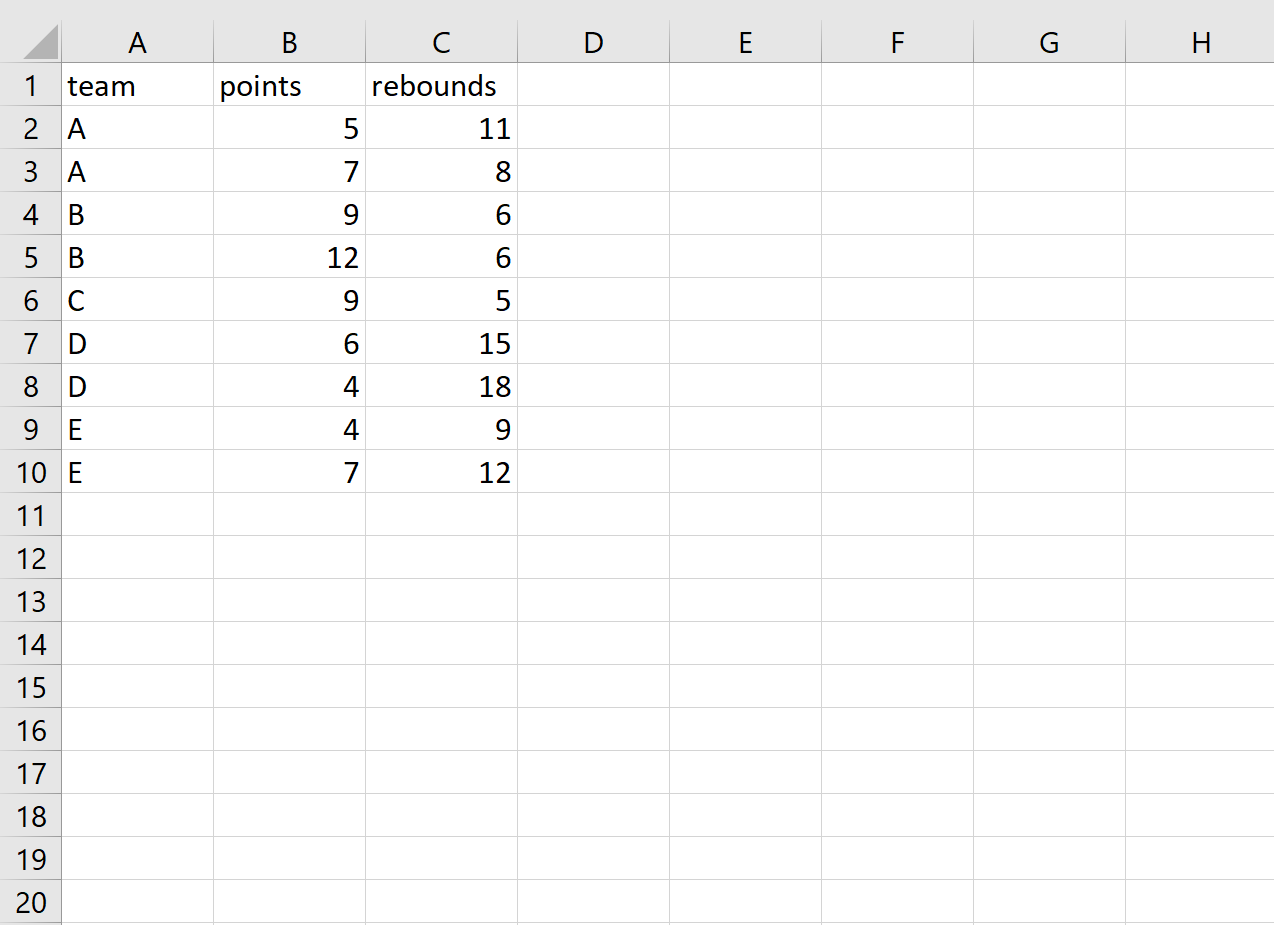
import pandas as pd #create DataFrame df = pd.DataFrame() #view DataFrame df team points rebounds 0 D 6 15 1 D 4 18 2 E 4 9 3 E 7 12 Шаг 3. Добавьте новые данные в существующий CSV-файл.
В следующем коде показано, как добавить эти новые данные в существующий CSV-файл:
df.to_csv('existing.csv', mode='a', index= False , header= False ) Шаг 4. Просмотрите обновленный файл CSV
Когда мы открываем существующий файл CSV, мы видим, что новые данные были добавлены:
Примечания по добавлению данных
При добавлении данных в существующий CSV-файл обязательно проверьте, есть ли в существующем CSV-файле столбец индекса или нет.
Если в существующем CSV-файле нет индексного файла, вам нужно указать index=False в функции to_csv() при добавлении новых данных, чтобы Pandas не добавляли индексный столбец.
Как сделать выгрузку DataFrame в CSV файл?
Сначала идет обработка DataFrame, она работает нормально, проверила через print() .
таблица_на_выгрузку = (таблица.groupby([таблица["столбец"]])).sum().reset_index() таблица_на_выгрузку['новый_столбец'] = 5*таблица.столбец Далее я пытаюсь выгрузить файл, с помощью .to_csv , но в файл выгружается неправильно. Все данные и столбцы загружаются в 1 столбец и также загружается пустой столбец, который обозначает нумерацию.
таблица_на_выгрузку.to_csv(r'C:\путь\название_файла для выгрузки.csv', sep=',') Как сделать так, чтобы все столбцы распределялись отдельно по своим местам, и чтобы пустой столбец с нумерацией не записывался в CSV файл? Также подскажите пожалуйста, как сделать так, чтобы путь генерировался автоматически, так как данное приложение будет закачиваться на сервер и использоваться, как веб-приложение на других ПК.
Чтение и запись табличных данных в файловую систему — Python: Pandas
Библиотека Pandas разрабатывалась для работы с табличными данными. Популярными типами файлов для их хранения являются:
- csv — текстовый формат, в котором значения в столбцах отделены друг от друга разделителем, часто запятой
- xlsx или xls — форматы файлов электронных таблиц Microsoft Excel
Для чтения и записи таблиц в указанные форматы в Pandas существуют специальные методы. О них пойдет речь в этом уроке.
Чтение данных
Начнем работу с продажами в сети из четырех магазинов за одну неделю, которые хранятся в формате csv с запятой в качестве разделителя. Воспользуемся методом read_csv() :
df_orders = pd.read_csv('./data/Shop_orders.csv') print(df_orders.head()) # => Weekday Shop_1 Shop_2 Shop_3 Shop_4 # 0 mon 7 1 7 8 # 1 tue 4 2 4 5 # 2 wed 3 5 2 3 # 3 thu 8 12 8 7 # 4 fri 15 11 13 9 При чтении данных метод не знает, что считать за индекс в данных, поэтому расставляет индексы самостоятельно. Это возрастающая последовательность целых чисел, которая начинается с нуля. В нашем примере явным индексом является первый столбец — Weekday. Дополним метод параметром index_col с явным указанием номера столбца, который хранит индексы:
df_orders = pd.read_csv('./data/Shop_orders.csv', index_col=0) print(df_orders.head()) # => Shop_1 Shop_2 Shop_3 Shop_4 # Weekday # mon 7 1 7 8 # tue 4 2 4 5 # wed 3 5 2 3 # thu 8 12 8 7 # fri 15 11 13 9 У разделителя в данных формата csv есть важное значение при чтении. По умолчанию это запятая. Попытка считать данные с разделителем в виде точки с запятой приведет к некорректному чтению. В примере ниже в результате получается пустой DataFrame , в котором индексами стали данные в строках — не то, что хотелось получить:
df_orders = pd.read_csv('./data/Shop_orders_sep.csv', index_col=0) print(df_orders.head()) # => Empty DataFrame # Columns: [] # Index: [mon;7;1;7;8, tue;4;2;4;5, wed;3;5;2;3, thu;8;12;8;7, fri;15;11;13;9] Для корректного чтения в данном случае достаточно воспользоваться параметром sep :
df_orders = pd.read_csv('./data/Shop_orders_sep.csv', index_col=0, sep=';') print(df_orders.head()) # => Shop_1 Shop_2 Shop_3 Shop_4 # Weekday # mon 7 1 7 8 # tue 4 2 4 5 # wed 3 5 2 3 # thu 8 12 8 7 # fri 15 11 13 9 Иногда описание данных может предшествовать началу самих табличных данных. В примере ниже файл начинается со строк:
Попытка прочитать данный файл повлечет ошибку:
df_orders = pd.read_csv('./data/Shop_orders_abstract.csv', index_col=0) print(df_orders.head()) # => ParserError: Error tokenizing data. C error: Expected 1 fields in line 4, saw 5 Чтобы пропустить ряд строк с описанием, нужно воспользоваться параметром skiprows . Его значение — это количество опускаемых из рассмотрения первых строк в файле:
df_orders = pd.read_csv('./data/Shop_orders_abstract.csv', index_col=0, skiprows=3) print(df_orders.head()) # => Shop_1 Shop_2 Shop_3 Shop_4 # Weekday # mon 7 1 7 8 # tue 4 2 4 5 # wed 3 5 2 3 # thu 8 12 8 7 # fri 15 11 13 9 Запись данных
После чтения и трансформации данных результаты могут быть сохранены в файловую систему. Для этого в Pandas есть ряд специальных методов. Для рассматриваемых типов данных это to_csv() и to_excel() :
df_orders.to_csv('./data/Shop_orders_restore.csv') В примере выше метод to_csv() позволяет сохранить DataFrame в изначальном виде. Если в качестве индекса сохранить значения, которые присвоены Pandas по умолчанию, то это может мешать дальнейшему чтению и обработке. Также такие индексы не несут важной информации.
У нас есть такие данные:
# => Weekday Shop_1 Shop_2 Shop_3 Shop_4 # 0 mon 7 1 7 8 # 1 tue 4 2 4 5 # 2 wed 3 5 2 3 # 3 thu 8 12 8 7 # 4 fri 15 11 13 9 Для них с индексами по умолчанию достаточно воспользоваться параметром index , чтобы не сохранять их файл:
df_orders.to_csv('./data/Shop_orders_restore.csv', index=False) В команде разработки можно проговорить, что будет использоваться в качестве разделителя в csv-файле. Также это может быть продиктовано совместимостью с другими частями программного продукта. Чтобы задать разделитель, нужно использовать параметр sep :
df_orders.to_csv('./data/Shop_orders_restore_sep.csv', index=False, sep=';') Метод to_excel() позволяет сохранять табличные данные в формат MS Excel. Параметризация аналогична методу to_csv() . Меняется только название метода и расширение файла с .csv на .xlsx :
df_orders.to_excel('./data/Shop_orders_restore.xlsx', index=False) В некоторых случаях сохранение названий столбцов также можно отключить. Это может потребоваться, когда нужно сохранить значения в ячейках таблицы, или когда названия столбцов не несут дополнительной информации, и не предполагается их использование. Для этого достаточно задать параметр header значением False:
df_orders.to_excel('./data/Shop_orders_restore_noheader.xlsx', index=False, header=False) Большие таблицы текстовых данных занимают большой объем. Чтобы уменьшить его, можно создавать архивы методами Pandas. Для этого нужно определить метод сжатия и названия файла в архиве, при этом указать их в виде словаря в параметре compression :
df_orders.to_csv( './data/Shop_orders_restore.zip', index=False, compression='method': 'zip', 'archive_name': 'Shop_orders_restore_archive.csv'> ) Выводы
Данные для долгосрочного хранения размещают в виде файлов на жестких дисках. В данном уроке методами библиотеки Pandas выполнялись операции чтения и записи csv и xlsx файлов — наиболее популярных форматов хранения табличных данных.
Данные форматы позволяют хранить таблицы в структурированной форме, но при этом данная форма может сильно варьироваться:
- Могут использоваться различные варианты разделителей значений в столбцах
- Строки описания данных могут появляться в шапке таблице
- Индексы могут храниться не в привычном крайнем левом столбце
В уроке на практических примерах показано, как действовать в таких ситуациях. Конфигурацией параметров методов мы научились:
- Пропускать первые строки в таблице
Открыть доступ
Курсы программирования для новичков и опытных разработчиков. Начните обучение бесплатно
- 130 курсов, 2000+ часов теории
- 1000 практических заданий в браузере
- 360 000 студентов
Наши выпускники работают в компаниях: