Как отобразить теги на веб-странице?
Любые теги (вроде
) никак не показываются в браузере, поскольку воспринимаются браузером как команды для вставки элементов и изменения их свойств. Но иногда требуется на веб-странице вывести теги, например, для демонстрации HTML-кода. В этом случае используйте спецсимволы < и > для замены угловых скобок < и >. При этом
будет выглядеть как <p> (пример 1).
Пример 1. Теги на веб-странице
Пример страницы
<!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title>Формула этанола</title> </head> <body> <p>Формула этанола С<sub>2</sub>Н<sub>5</sub>ОН</p> </body> </html>
В данном примере выводится код веб-страницы, а чтобы браузер не воспринимал теги напрямую, скобки < и >заменены специальными символами < и >. Результат примера показан на рис. 1.
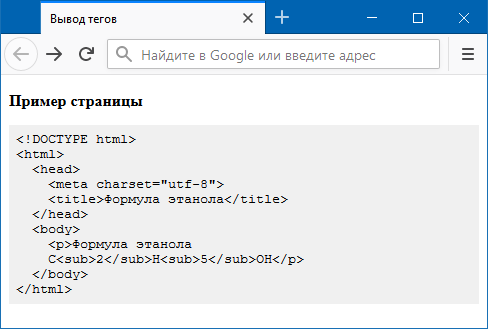
Рис. 1. Теги в документе
См. также
- Работа с текстом
- Типографика в Bootstrap 5
Отладка HTML
Написать HTML — здорово, но как понять, где ошибка, когда что-то не работает? В этой статье описаны несколько инструментов, которые помогают искать и исправлять ошибки в HTML.
| Что нужно знать: | Базовые знания HTML на уровне Начало работы с HTML, Основы редактирования текста в HTML, и Создание гиперссылок. |
|---|---|
| Чему вы научитесь: | Искать проблемы в HTML с помощью инструментов отладки. |
Отладка — это не страшно
Во время написания какого-нибудь кода, обычно все идёт хорошо, пока не появляется тот момент, когда вы совершаете ошибку. Итак, ваш код не работает, или работает не так, как вы задумывали. Если вы попытаетесь скомпилировать неработающую программу на языке Rust, компилятор укажет на ошибку:
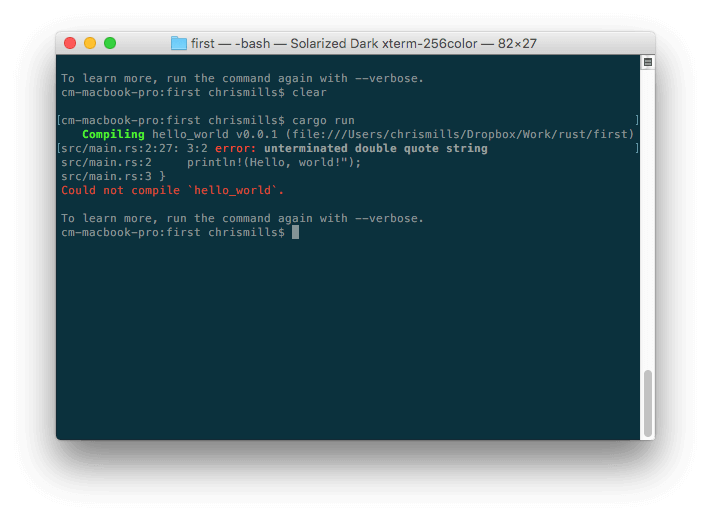
В данном случае, сообщение об ошибке понять относительно просто — «unterminated double quote string». Если вы внимательно посмотрите на println!(Hello, world!»); , то заметите, что здесь отсутствует двойная кавычка. Разумеется, сообщения об ошибках могут становиться куда более сложными для понимания по мере роста вашего кода, и даже самые простые случаи могут показаться пугающими для тех, кто ничего не знает о Rust.
Но не бойтесь отладки! Чтобы комфортно писать и отлаживать любой код, нужно понимать язык и его инструменты.
HTML и отладка
HTML не так сложен к пониманию, как Rust. HTML не компилируется в какую-либо другую форму перед тем, как браузер проанализирует это и покажет результат (он является интерпретируемым, а не компилируемым). Синтаксис HTML элементов намного понятнее, чем у «настоящих языков программирования», таких как Rust, JavaScript, или Python (en-US). Способ, которым браузеры читают HTML более толерантен, чем у языков программирования, интерпретирующих свой код строже. Это одновременно и плохо, и хорошо.
Толерантный код
Так что же означает толерантный? В общих чертах, когда вы напортачили в коде, есть два типа ошибок, с которыми вы столкнётесь:
- Синтаксические ошибки (Syntax errors): Это ошибки в правильности написания, как это было выше, в примере с Rust. Такие обычно легко исправлять, в той мере, в какой вы знакомы с синтаксисом языка и знаете, что означают сообщения об ошибках.
- Логические ошибки (Logic errors): Это ошибки, появляющиеся в том случае, если синтаксис корректен, но код не выполняет своего предназначения, то есть программа выполняется неверно. Такие исправлять сложнее, чем синтаксические, поскольку не выводится сообщений, указывающих место, где вы ошиблись.
HTML не страдает от синтаксических ошибок, потому что браузер читает код толерантно, в том смысле, что страницы могут отображаться даже если синтаксические ошибки присутствуют. Браузеры имеют встроенные правила по интерпретации неверно написанной разметки, и вы можете запустить что-либо, даже если вы имели в виду другое. Это может стать настоящей проблемой!
Примечание: HTML читается толерантно, потому что когда веб только появился, было решено позволить людям публиковать контент даже при условии некорректностей в коде, так как это куда более важно, чем уверенность в абсолютно верном синтаксисе. Веб не был бы сейчас так популярен, если бы относился к новичкам строго.
Активное обучение: Знакомство с толерантным кодом
Время изучить природу толерантного кода в HTML.
- Для начала, скачайте наш пример отладки и сохраните локально. Эта демонстрация намеренно написана с ошибками, которые нам предстоит обнаружить.
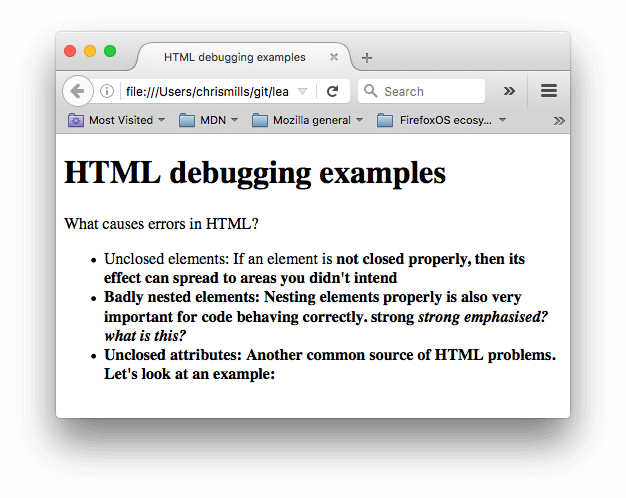
- Далее, откройте её в браузере. Вы увидите нечто вроде этого :
- Сейчас документ выглядит не особо хорошо; Давайте посмотрим в код и выясним почему (Показано только тело документа):
h1>HTML debugging examplesh1> p>What causes errors in HTML? ul> li>Unclosed elements: If an element is strong>not closed properly, then its effect can spread to areas you didn't intend li>Badly nested elements: Nesting elements properly is also very important for code behaving correctly. strong>strong em>strong emphasised?strong> what is this?em> li>Unclosed attributes: Another common source of HTML problems. Let's look at an example: a> ul>
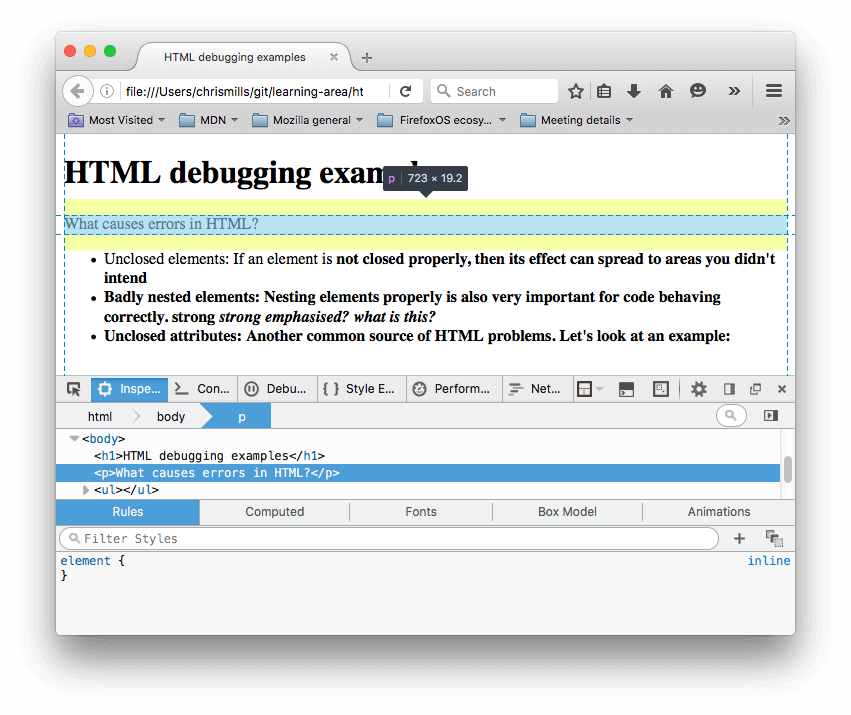
- У параграфа и элемента списка не закрыты теги. На изображении выше видно, что разметка не пострадала, так как браузеру легко сделать вывод о том, где заканчивается один элемент и начинается другой.
- Первый элемент также не имеет закрывающего тега. Это уже более проблематично, так как сложно сказать, где элемент должен заканчиваться. На деле, весь оставшийся текст был выделен жирным.
- Следующая часть нарушает правила вложенности: strong strong emphasised? what is this? . В этом случае код тоже сложно проинтерпретировать по причине, описанной выше.
- В атрибуте href отсутствует закрывающая двойная кавычка. Это послужило причиной крупной проблемы — ссылка не воспроизвелась вовсе.
- Параграфы и элементы списка получены с закрывающими тегами.
- Было неочевидно, где элемент должен был закрыться, так что браузер обернул каждый отдельный блок текста своими собственными тегами strong, причём до самого низа документа!
- Некорректная вложенность была исправлена браузером следующим образом:
strong >strong em>strong emphasised?em> strong> em> what is this?em>
li> strong >Unclosed attributes: Another common source of HTML problems. Let's look at an example: strong> li>
Валидация HTML
Из примера выше ясно, что стоит проверять валидность HTML. В простом примере сверху можно просто просмотреть весь код и найти ошибки, но как быть с огромными, сложными страницами?
Лучше всего проверить страницу в сервисе валидации разметки. Его создал и поддерживает W3C — организация, которая занимается спецификациями HTML, CSS и других веб-технологий. Сервис проверит ваш HTML и составит отчёт по ошибкам в нем.
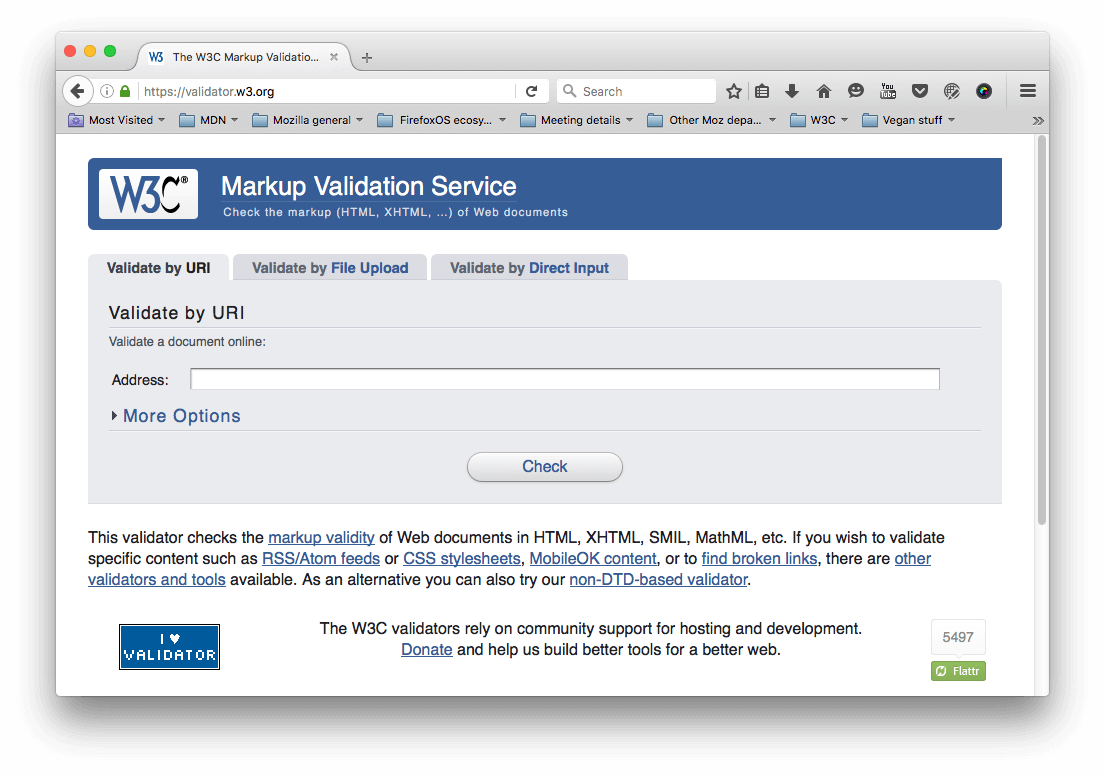
HTML можно проверить по адресу, загрузив файл или напрямую ввести код HTML.
Активное обучение: Валидируем HTML-документ
- Откройте сервис валидации разметки в браузере.
- Перейдите в режим Validate by Direct Input.
- Скопируйте весь код документа (не только body) и вставьте в место для ввода.
- Нажмите на Check (проверить).
Вы увидите список ошибок и другую информацию.
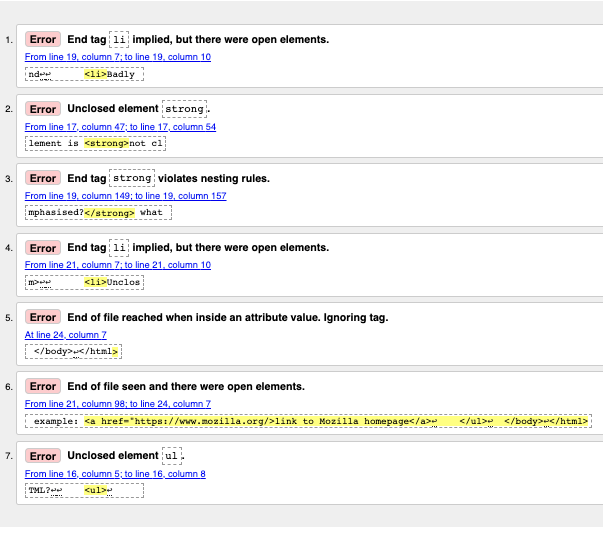
Работа с сообщениями об ошибках
Обычно сразу ясно, что значат сообщения, но иногда приходится постараться, чтобы понять, в чем дело. Сейчас мы пройдёмся по всем ошибкам и разберём, что они значат. Обратите внимание, что в сообщениях указаны строка и столбец кода, чтобы ошибки было проще искать.
Если некоторые ошибки кажутся вам странными, начните исправление с остальных и проверьте документ ещё раз. Иногда одна ошибка ломает большую часть документа.
Когда вы увидите эту надпись, в вашем документе больше нет ошибок:

Заключение
Теперь вы умеете отлаживать HTML. С новыми знаниями вам будет проще разобраться и в отладке более сложных языков — например, CSS и JavaScript. На этом мы заканчиваем вводный модуль курса HTML — время попробовать свои силы в упражнениях.
Использую php. Почему код html выводится как текст?
SEO.Taxi — Экспертное SEO Продвижение Сайта (https://SEO.Taxi) — подвезу в ТОП Платные консультации по продвижению.
На сайте с 04.02.2008
2 июля 2008, 14:47
Пример в студию.
На сайте с 17.03.2007
2 июля 2008, 14:48Давно сам с php не практиковался, но, если мне не изменяет память, данная ошибка возникает, когда Вы html выводите через код php, заключая в двойные кавычки. Двойные поменяйте на одинарные
На сайте с 23.05.2007
2 июля 2008, 14:48Прим:
$ssilka="сайт";
print "$ssilka";
И выдает текстом сайт
При просмотре html кода страницы:
<a target=_blank href="http://perestroim.net">сайт</a>На сайте с 28.01.2006
2 июля 2008, 14:51
Потому что надо Content Type выставить. либо в PHP либо в заголовке документа.
кстати да и с кавычками у вас косяк.
За клиента на продвижение, откат 20% (http://qjp.ru/index.php/2009-03-04-06-46-45)
На сайте с 23.05.2007
2 июля 2008, 14:55
content-type выставлен. щас с кавычками попробую.
На сайте с 04.02.2008
2 июля 2008, 14:55Light Phantom:
Давно сам с php не практиковался, но, если мне не изменяет память, данная ошибка возникает, когда Вы html выводите через код php, заключая в двойные кавычки. Двойные поменяйте на одинарныеНеа, работают оба варианта:
echo 'сиськи';
echo '
';
echo "сиськи";
На сайте с 28.01.2006
2 июля 2008, 14:59$ssilka="HELLO";
echo $ssilka;Либо экранировать кавычки если нужны двойные
$ssilka="HELLO";
echo $ssilka;Включение отображения HTML-кода для веб-части результатов федеративного поиска
Дата последнего изменения: 1 мая 2010 г.
Применимо к: SharePoint Server 2010
В этой статье
Шаг 1. Проверка отображения HTML-кода (необходимо убедиться, что HTML-код не удален и отображается)
Шаг 2. Отключение escape-знаков
Шаг 3 (необязательно). Отключение усеченияПо умолчанию в XSLT-преобразовании веб-части результатов федеративного поиска отображение HTML-кода отключено из соображений безопасности. Однако в некоторых случаях требуется отображать в веб-части результатов федеративного поиска поле, содержащее HTML-код из надежных источников. Для этого можно внести следующие изменения в свойство XSL федеративного расположения или веб-части результатов федеративного поиска:
- Убедитесь, что HTML-код отображается.
- Отключите кэширование вывода.
- Отключите усечение (необязательно).
Эти изменения описываются в данном разделе.
Если обновляется свойство XSL федеративного расположения, следует убедиться, что эта веб-часть настроена для использования сведений об отображении расположения.
Настройка веб-части результатов федеративного поиска для использования сведений об отображении расположения
- В браузере перейдите по URL-адресу страницы результатов. Например, http:// имя_сервера/results.aspx.
- Выберите пункт Действия сайта и затем команду Изменить страницу.
- В экземпляре веб-части результатов федеративного поиска, которую нужно изменить, щелкните стрелку правка для отображения меню Веб-часть, а затем выберите пункт Изменить веб-часть.
- В области инструментов веб-части результатов федеративного поиска разверните раздел Отображать свойства.
- Выберите параметр Использовать визуализацию расположения.
- Нажмите кнопку ОК для обновления экземпляра веб-части результатов федеративного поиска.
Шаг 1. Проверка отображения HTML-кода (необходимо убедиться, что HTML-код не удален и отображается)
Перед включением отображения HTML-кода требуется изучить структуру XML-кода, возвращаемого в веб-часть результатов федеративного поиска, а также XSLT-файла, который обеспечивает преобразование этого XML-кода. Дополнительные сведения об изменении свойства XSL федеративного расположения или веб-части см. в статье Просмотр и изменение преобразования XSLT для результатов поиска. Чтобы просмотреть XML-данные результатов поиска, возвращаемые федеративным расположением, выполните действия, описанные в статье Просмотр XML-данных результатов поиска.
Убедитесь, что узел XML, данные которого требуется отображать, содержит HTML-код. Обратите внимание, что этот код не отображается на странице, поскольку в XSLT-файле отключено отображение HTML-кода. Например, следующий тег в шаблоне GetPlainTextFromHtml определяет удаление HTML-кода из поля description RSS-канала:
Измените тег для вывода значения $Html без вызова шаблона GetPlainTextFromHtml.
По умолчанию XSLT-файл для расположения OpenSearch отображается в полях title, link и description RSS-канала OpenSearch. Изменения следует вносить только в поле description стандартного канала RSS или ATOM. Дополнительные сведения о настройке отображения заголовка см. в статье Настройка заголовка и фирменного значка для веб-части результатов федеративного поиска.
После сохранения изменений в федеративном расположении или веб-части результатов федеративного поиска теги HTML отображаются на странице в виде знаков, предваряемых обратной косой чертой. Например, вместо отображаемого HTML-кода могут выводиться угловые скобки (<>). На следующем шаге показан порядок изменения такого поведения.
Шаг 2. Отключение escape-знаков
Найдите тег , для которого требуется отображать выходные данные. Например, чтобы отображать HTML-код из поля description канала RSS или ATOM, найдите следующий тег.
Добавьте атрибут disable-output-escaping, как показано ниже.
Атрибут disable-output-escaping принудительно задает для тега вывод HTML-кода без escape-знаков. Это может привести к выводу поврежденного HTML-кода. Поэтому данный атрибут следует использовать с осторожностью и только для отображения HTML-кода из надежных источников.
Шаг 3 (необязательно). Отключение усечения
Поскольку значение $DescText в ранее измененном теге является усеченным, HTML-код в поле description может быть усечен до того, как будет завершено формирование тегов. Это может привести к неправильному отображению HTML-кода.
Чтобы гарантировать правильное отображение HTML-кода, измените значение select для тега, задав в нем использование полного значения.